palette = ({
  naipca_iab: "#18557f", complete: "#18557f",
  qz_ipca: "#8a6a1a",
  ipca: "#6f9cc0", rp_pca: "#7a7a7a", ff5: "#b3b3b3",
  naipca_beta_only: "#8a8378", beta_only: "#8a8378",
  band: "rgba(0,0,0,0.06)", muted: "rgba(0,0,0,0.6)", rule: "rgba(0,0,0,0.1)"
})
LANG = (document.documentElement.lang || "en").startsWith("zh") ? "zh" : "en"
STR = ({ en: { view: "View", cost: "Cost (bp per traded dollar)", universe: "Universe", sample: "Sample (months)", log: "Log scale", models: "Models", statistic: "Statistic", theme: "Theme", sort: "Sort by", method: "Method", scenario: "Scenario", block: "Block (months)", metric: "Metric", intervals: "Intervals", cost_bp: "One-way cost (bp)", failed: "Interactive data failed to load. The static figure is shown instead." },
        zh: { view: "视图", cost: "成本(每交易一美元,基点)", universe: "股票池", sample: "样本(月)", log: "对数坐标", models: "模型", statistic: "统计量", theme: "主题", sort: "排序", method: "方法", scenario: "情景", block: "块长(月)", metric: "指标", intervals: "区间", cost_bp: "单边成本(基点)", failed: "交互数据加载失败,改为显示静态图。" } })
t = (k) => STR[LANG][k] ?? STR.en[k] ?? k
fmt2 = (x) => (x == null || Number.isNaN(x)) ? "n/a" : x.toFixed(2)
fmt1 = (x) => (x == null || Number.isNaN(x)) ? "n/a" : x.toFixed(1)
fmtBp = (x) => (x == null || Number.isNaN(x)) ? "> 500" : `${Math.round(x)} bp`
parseMonth = (s) => new Date(`${s}-01T00:00:00Z`)
// Sharpe, annualised, sample std (ddof = 1): matches the release convention
sharpe = (r) => {
  const n = r.length, m = r.reduce((a, b) => a + b, 0) / n
  const v = r.reduce((a, b) => a + (b - m) ** 2, 0) / (n - 1)
  const vol = Math.sqrt(v) * Math.sqrt(12)
  return vol > 1e-12 ? (m * 12) / vol : NaN
}
netSeries = (r, to, bp) => r.map((x, i) => x - to[i] * bp / 1e4)
wealthPath = (r) => { let w = 1; return r.map((x) => (w *= 1 + x)) }
nberMarks = (nber) => Plot.rectX(nber, { x1: (d) => parseMonth(d.start), x2: (d) => parseMonth(d.end), fill: palette.band })如何解读估计的定价误差:来自基于特征的收益预测的证据
Interpreting Estimated Pricing Errors: Evidence from Characteristic-Based Return Forecasts
一个模型报告的阿尔法更小,是因为它的因子解释得更多,还是因为被解释的对象变了?阿尔法的大小能帮研究者挑选或改进收益预测吗?
工作论文 · 2026 年 9 月 · 62 页 · 尚未在 SSRN 发布
模型对每只股票预期收益的估计,也就是它的预测,可以拆成因子能生成的部分和剩下的阿尔法(alpha,即估计的定价误差)。三个问题,三个回答。为什么一个模型的阿尔法比另一个小?主要因为它解释的是另一份预期收益估计。基于 153 个美国股票特征,同一个模型训练两次(一次各股票等权,一次按市值加权);在等权计分下,两者各自的阿尔法约为每月 117 和 77 个基点(1 个基点即 0.01 个百分点)。给第一个模型换上第二个的因子,它的未解释部分仍约为 117 个基点;换上第二个的估计,就降到 75 个基点(表 1,第 13 页)。阿尔法的大小能帮研究者挑预测吗?帮助不大。把预测中的阿尔法部分调小有用吗?有时有用,取决于比较基准和训练窗口。
1 研究问题
在整个研究主线中,本文接在《特征空间度量》之后,回答的是:既然尺子(见下方方框)能把收益在因子与截距(本模型中没有被任何因子解释的那部分预期收益)之间挪动,那么“更小的阿尔法”意味着什么?下一篇《特征几何》从解读模型走向依据模型行动:预测不变时,尺子还能改变投资组合吗?
一个模型“解释不了的收益”变少了,是因为它的因子更好,还是因为它解释的是另一份预期收益估计?这个未解释部分的大小,能帮研究者挑选或改进收益预测吗?
基于特征的模型直接由特征给出每只股票的预期收益估计,也就是它的预测;它的因子另外规定了哪些收益模式算“已解释”。于是预测可以拆成因子能生成的部分和剩下的阿尔法成分(第 2.3 节,第 7 页)。本文用两种训练权重(模型如何拟合)把同一个模型各训练一次:一次每只股票一视同仁(等权模型),一次按市值加权(市值加权模型)。
尺子,以及本文为何固定它。 要说清一只股票的预期收益有多少归功于哪个驱动因素,模型得先判断两个特征方向是否真的不同、各自有多大。做这个判断的规则,就是尺子。给每个特征一个权重再相加,每只股票就得到一个分数;这样的加权组合称为特征方向(它不是投资组合)。普通尺子(欧氏度量)只看方向的权重本身;特征尺子(格拉姆度量)则看这个方向给真实股票打出的分数:分数通常有多大,两个方向的分数在股票之间是否同高同低。尺子,是模型用来衡量一个特征方向有多大、两个特征方向重叠多少的规则。两个价值信号若总是选中同一批便宜的股票,特征尺子会把它们算作重叠,普通尺子却把它们当作互不相关。
尺子也把每个未解释部分换算成以基点计的大小。两个阿尔法用同一把尺子、在同一批股票上、按同一组计分权重(未解释部分如何衡量:每只股票等权,或按市值加权)衡量。在主要的交叉比较中,尺子是全样本(1963 年 7 月至 2025 年 11 月)逐月特征尺子的平均(表 1,第 13 页);年度选择检验则改用前 60 个月的平均(第 3.3 节,第 10 页)。无论哪种,它衡量的都是信号大小,不是组合风险(第 6 页)。本文固定这把尺子,公平的比较理应如此:两个模型的估计和因子都不同,尺子始终相同。
2 为什么重要
阿尔法更小,常被当作证据,说明新模型的因子更好。如果差距主要来自预期收益估计的变化,那么这个论证比较的其实是估计,而不是因子(第 2 页)。所以,建模者应当追问:更小,是相对于哪一份预期收益估计而言?团队若要决定采用哪个预测、保留多少阿尔法成分,都可以用之后的收益来检验。
3 论证脉络
- 拆分。 阿尔法变小,可能因为因子更好,也可能因为估计换了。→ 理论框架
- 难点。 直接比较两个模型各自的阿尔法,会把两个原因搅在一起。→ 为什么重要
- 设计。 让每个模型的估计分别面对每个模型的因子,用同一把尺子衡量。→ 一个简单例子
- 发现一。 只换因子,未解释部分几乎不动;只换估计,差距便被抹平。→ 表 1
- 发现二。 每年挑阿尔法较小的模型,对下一年的预测精度帮助不大。→ 图 2、表 2
- 发现三。 把阿尔法成分按历史校准调小,在 24 个检验设定中有 20 个比全部保留预测更准,但只有 8 个比简单平均更准。→ 图 3
- 边界。 先弄清是什么变了,再把每种用法与简单的替代方案比一比;证据是探索性的,不是阿尔法是否为零的检验,也不是交易结果。→ 适用范围
4 理论框架
出发点是定价误差 \alpha_t = \mu_t - \beta_t \lambda_t:预期超额收益 \mu_t,减去因子暴露 \beta_t(股票随各因子变动的强弱)与风险价格 \lambda_t 所能解释的部分(式 (1),第 5 页)。它以每月百分比计。它是一个期望量,不是已实现收益中的噪声;不为零本身也不能证明存在错误定价。
实证模型是一个基于特征的因子模型,设定沿用工具化主成分分析(IPCA)(Kelly 等 2019)。特征通过载荷矩阵 B 决定每只股票在几个潜在因子上的载荷,另通过单独的截距系数向量 a 决定它的截距(式 (2),第 5 页)。潜在因子是模型从数据中推断的共同驱动因素;载荷即上文的暴露。用符号表示,记 \hat h 为模型的预期收益系数:
\begin{aligned} \hat h &= \underbrace{P_Q(B)\,\hat h}_{p:\ \text{因子部分}} + \underbrace{[I - P_Q(B)]\,\hat h}_{r:\ \text{阿尔法成分}},\\ h(\eta) &= p + \eta\, r,\qquad \eta \in [0,1]. \end{aligned}
第二行保留全部 p,只保留 r 的一个比例 \eta(式 (14),第 21 页):\eta = 1 即完整预测,\eta = 0 则只剩因子部分。
给专业读者:投影与尺子
若把因子的均值设定为吸收因子所能再现的全部内容,留在外面的 r 恰好就是模型拟合出的特征阿尔法(式 (6),第 7 页)。P_Q(B) = B(B'QB)^{-1}B'Q 把系数投影到载荷空间上,即模型的暴露所能生成的全部收益信号。Q 是按等权或市值加权构造的特征格拉姆矩阵,使 b'Qb 衡量两组系数对所研究股票的预测相差多少(式 (3) 至 (5),第 6 页)。在交叉比较中,每一种配对都取最适合其目标的因子均值(第 7 页)。
5 一个简单例子
两位裁缝各自报告版型和客人差多少。裁缝 B 报的差距更小,可 B 做的是一位身材更标准、两个版型都合身的客人。要比较版型,就把两个版型分别套在两位客人身上,这就是论文的 2×2 交叉(A 为等权模型,B 为市值加权模型)。套在 A 的客人身上,两个版型差不多合身(117.37 对 116.67 个基点);套在 B 的客人身上,连 A 的版型也只差 75.02 个基点(表 1,第 13 页)。这里,版型是模型的因子,客人是预期收益估计,不合身的程度是阿尔法。真正的客人谁也看不见:两位“客人”都是对不可观测的预期收益的估计,所以交叉比较只说明变的是哪一样,不说明哪份估计更对,判断这一点要靠之后的收益。
试一试。 模型 A 的估计里有一种个股偏离,它的因子无法生成;两个滑块改变的是模型 B。示例默认处于“情形 1”:先点“重置”,再依次点两个情形,留意右上和左下两格。
图 1:两个模型,两个阿尔法。五只股票、一个因子的示意数字;表格让每个模型的估计分别面对每个模型的因子。
怎么读。每根柱子是一只股票的预期收益估计,拆成因子部分(蓝色)和阿尔法成分(金色),圆点为合计。表格(每月基点)中,加粗的格子是各模型自己的阿尔法。来源:示意数字,并非论文数据;版式参照论文表 1。
留意。 与“重置”相比,两种情形下 B 自己的阿尔法(右下格)都变小了。情形 1 中右上格下降,说明 B 的估计本身更容易被解释;情形 2 中左下格下降,说明 B 的因子更能解释 A 的估计。只有交叉组合能告诉你是哪一种情形。论文的实际数据更像情形 1(表 1,第 13 页)。再拖动滑块:B 的因子倾斜程度等于其估计保留的偏离时,B 自己的阿尔法降为零,越过后又回升。示例只有一个因子、五只等权股票,B 的估计只是按比例缩小 A 的偏离;论文中估计的变化还涉及方向(第 14 页)。
6 研究设计与主要结果
数据是与 Jensen 等 (2023) 特征库相对应的美国股票面板:153 个特征,1963 年 7 月至 2025 年 11 月(第 3.1 节,第 8 页)。预测对象是次月超额收益,并按每月第 1 和第 99 百分位缩尾。本文在 2017 至 2025 年每年 3 月发布预测,共九个预测日期,称为起点。目标月从 2017 年 4 月到 2025 年 12 月,共 105 个月;预测始终只用更早的数据(第 3.2 节,第 9–10 页)。预测精度用预测 R^2 衡量:与“永远预测为零”相比,预测把平方误差降低了多少(式 (11),第 11 页)。
1. 为什么一个模型的阿尔法更小?
表 1:每个模型的预期收益估计与每个模型的因子交叉组合。 未解释部分在全样本特征尺子下的大小(各股票的均方根),每月基点;等权计分;3 个因子(表 1,第 13 页)。
| 因子的训练方式 | 估计来自等权训练 | 估计来自市值加权训练 |
|---|---|---|
| 等权训练 | 117.37 | 75.02 |
| 市值加权训练 | 116.67 | 77.27 |
怎么读。加粗的格子是各模型自己的阿尔法;另外两格显示,一个模型的因子能把另一个模型的估计再现到什么程度。沿列往下读只换因子,沿行往右读只换估计。若加粗两格的差距来自更好的因子,沿左列往下读就能弥合大部分;若来自另一份估计,则要沿首行往右读。
这说明什么。 估计相同、因子不同:未解释部分几乎不动(117.37 对 116.67 个基点)。因子相同、估计不同:降到 75.02 个基点(表 1,第 13 页)。对平方差距做对称分解,约 101% 归于估计的变化,−1% 归于因子的变化。这 −1% 是一个小小的抵消:对市值加权模型的估计,等权模型的因子留下的反而略少(75.02 对 77.27 个基点)。在市值加权计分下,两者分别为 98% 和 2%(第 13 页)。这些份额描述的是大小,不是因果效应。
2. 阿尔法的大小能帮研究者挑预测吗? 检验的规则是:在每个起点,发布历史未解释部分较小的那个模型的预测,再看它下一年是否更准(第 5.1 节,第 17 页)。若用各模型自己的估计来比阿尔法,每次都会选市值加权训练的模型。更公平的做法,是用一份共同的估计来检验两个模型的因子:在同一段历史上拟合的岭回归,即用特征预测收益、系数向零收缩的回归(第 10–11 页)。相对这份估计,市值加权模型的未解释部分小多少,就是它的诊断优势。
图 2:诊断优势与随后的预测差异。 九个年度起点,共同岭回归估计,前 60 个月的特征尺子(图 2,第 18 页)。
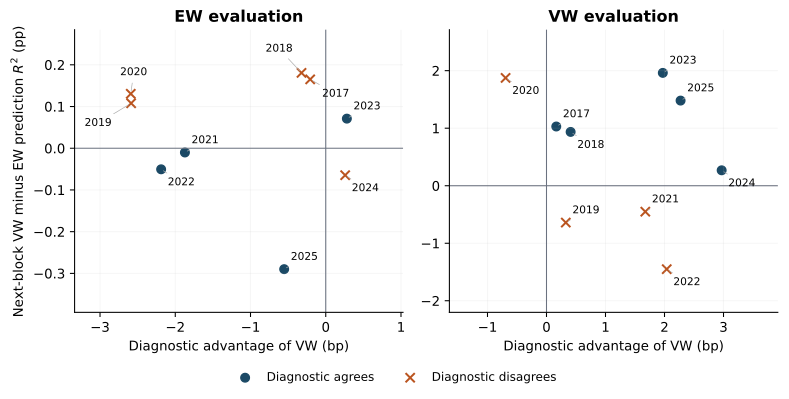
怎么读。零点右侧表示诊断优势偏向市值加权(VW)模型;零点上方表示该模型随后预测得更好。位于右上或左下象限的圆点是判断正确,叉号是判断错误。EW/VW 即等权/市值加权计分;2025 年区间只有九个月。来源:Interpreting Estimated Pricing Errors,工作论文,2026 年 9 月,图 2。
这说明什么。 诊断优势相近,随后的结果却可能截然相反。在市值加权计分下,2022 年起点的诊断偏向市值加权模型约 2.04 个基点,该模型随后的预测 R^2 却落后 1.45 个百分点。2023 年起点的诊断优势与之相近(1.97 个基点),该模型随后则领先 1.96 个百分点。平衡准确率(按事后哪个模型更准把年份分组,各组选对比例的平均)在等权计分下为 47.5%,在市值加权计分下为 41.7%,都低于永远选同一个模型的 50%(第 18 页)。
表 2:各预测规则在共同样本期内的精度。 预测 R^2(%,越大越好),105 个月,2017 年 4 月至 2025 年 12 月(表 3,第 19 页)。
| 预测规则 | 等权计分 | 市值加权计分 |
|---|---|---|
| 等权训练的模型 | 0.3605 | 0.5678 |
| 市值加权训练的模型 | 0.3788 | 1.0491 |
| 用共同岭回归估计挑选 | 0.3612 | 0.7326 |
| 两个模型预测的简单平均 | 0.4396 | 0.9569 |
| 混合岭回归 | 0.3972 | 0.8550 |
怎么读。挑选规则每年从两个因子模型中选一个,发布它的预测;混合岭回归直接对特征做一次岭回归,绕开因子模型。
这说明什么。 在主设定下,用共同估计按阿尔法大小挑选,两种计分方式下的预测都不如简单平均准(表 3,第 19 页);在更宽的 12 组决策序列中,它只有 5 组胜过简单平均(第 20 页)。简单平均是一个很难被超越的基准,但也不是每次都赢:市值加权计分下,市值加权训练的模型(1.0491%)就高于它。在平方损失下,简单平均的损失,等于两个预测各自损失的均值,再减去二者平方分歧的四分之一(式 (13),第 20 页)。若尺子改为整个训练窗口的平均,等权计分下挑选规则在 9 年中选对的年数由 4 年升至 6 年;但它的预测 R^2(0.3847%)仍低于简单平均(第 20 页)。
3. 把阿尔法成分调小有用吗? 一个模型的阿尔法成分保留多少,由比例 \eta 决定:它用此前十二个已完成的预测月学得,限制在 0 到 1 之间,再用于下一年(第 6.2 节,第 22 页)。图 3 把这一规则与四个基准比较(“比较基准”菜单):全部保留;简单平均;特征主成分(PC)版本,即不用模型的因子,改沿特征在股票间变动最大的方向来拆分同一份估计;以及用一个学得的比例整体缩放预测。
图 3:把阿尔法成分按历史校准调小,与所选基准比较。 预测 R^2 的提高(百分点),24 个检验设定,93 个月(首年只用于学习保留比例)(表 G.1,第 55 页)。
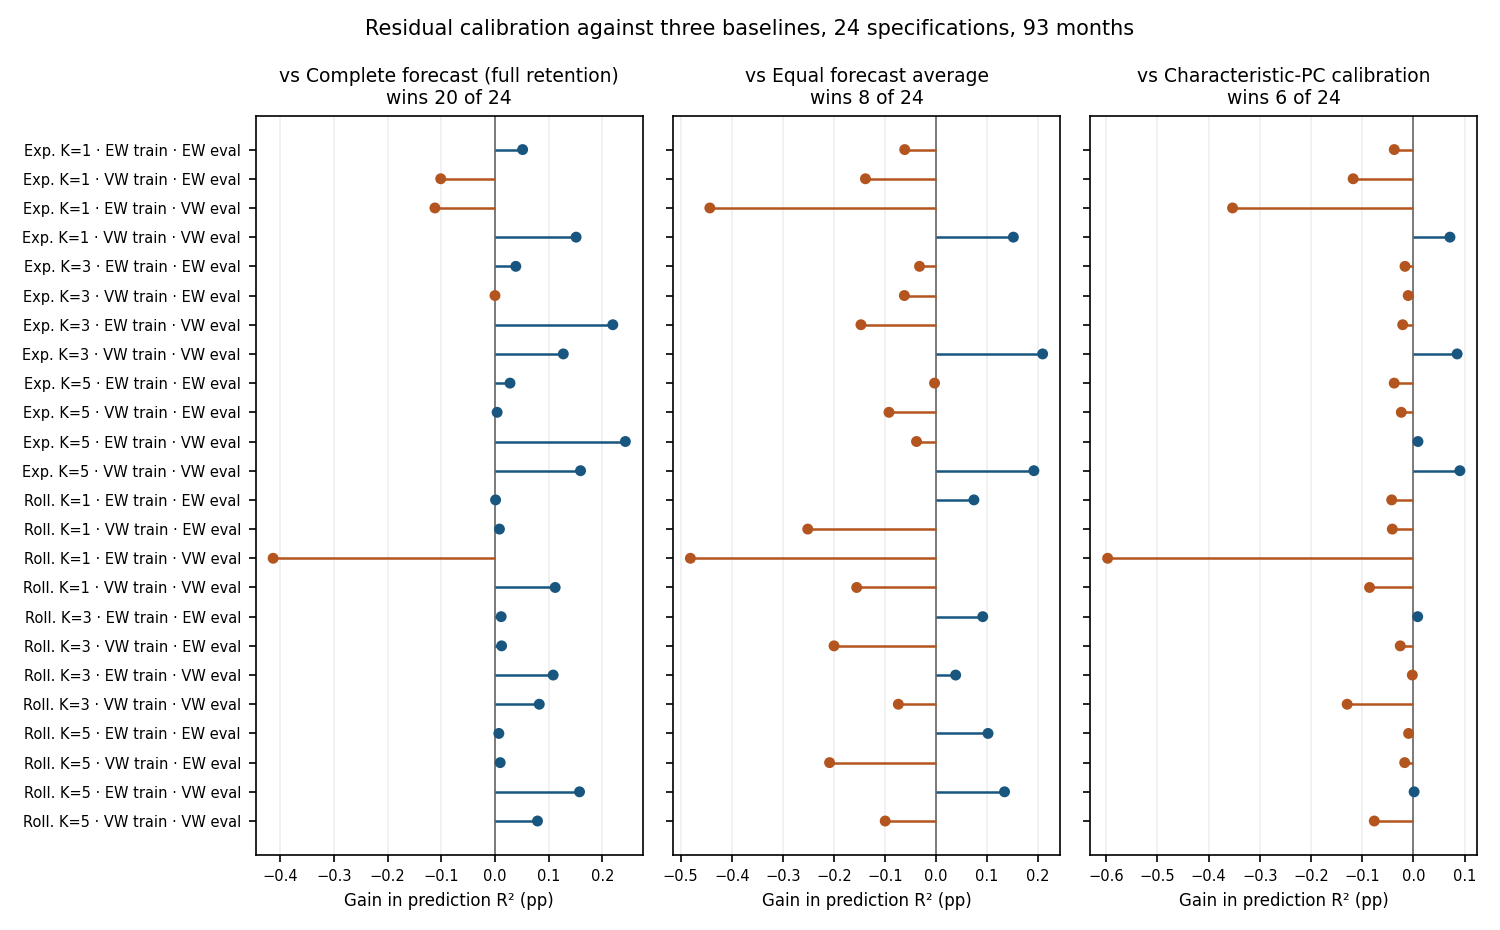
这说明什么。 把阿尔法成分按历史校准调小,在 24 个检验设定中有 20 个比全部保留预测更准;但比两个模型预测的简单平均更准的只有 8 个,比特征主成分版本更准的只有 6 个(摘要;表 G.1,第 55 页)。在按市值加权训练并评估时,相对简单平均的优势在扩展窗口下为正,在滚动窗口下为负(论文图 3,第 25 页)。阿尔法成分可能含有有用的预测信息;但预测更准,并不表明它代表被定价的风险(第 26 页)。
7 与既有文献的比较
| 既有研究 | 已有结论 | 本文的补充 |
|---|---|---|
| Kelly 等 (2019) | 由特征决定股票的因子载荷;截距刻画与特征相关、但并非来自因子暴露的收益。 | 追问拟合截距的大小变化反映了什么。 |
| Zhang (2024) | 检验“含潜在因子、以公司特征为协方差”的模型的定价误差。 | 不提出新检验,而是对拟合对象及其预测用途做匹配比较。 |
| Choi and Yuan (2025) | 对“内部”和“外部”阿尔法的估计与推断,含去偏处理。 | 回答不同的问题:报告的拟合阿尔法下降反映了什么;不与这些估计量比较优劣(第 59 页)。 |
| Kozak 等 (2020) | 对基于大量特征组合的随机贴现因子做收缩,样本外表现良好。 | 把岭回归作为基准;把保留部分阿尔法成分当作一个单独的收缩决策。 |
所依据的工具(投影、岭回归和预测平均)早已为人所知;本文的新意在于一套匹配设计:在相同的股票、日期和损失函数下,把上面三个问题分开。简言之:主要是估计换了;帮助不大;有时有用。不利的设定与有利的结果一并报告。
本文在表示恒等式处引用《特征空间度量》(第 4 页) (Liu 2026),固定这把尺子,追问“估计的阿尔法更小”对收益预测意味着什么。本文有意止步于预测;《特征几何》与求职论文把主线推进到投资组合。
本文与《特征几何》都在问模型“剩下的部分”值多少,但场景不同。本文把一个基于特征的模型的阿尔法成分调小,使平方误差意义下的预测更准。《特征几何》则在同一次无套利 IPCA(NA-IPCA)拟合内,把截距纳入预期收益,衡量未计交易成本的组合夏普比率;NA-IPCA 是以特征尺子重建、并为截距可承载的预期收益设上限的 IPCA。两者的模型、目标和样本都不同,因此既不相互印证,也不相互矛盾。
8 适用范围
- 不是定价误差检验。 这些比较并不检验总体(真实)阿尔法是否为零(附录 I.2,第 60 页)。
- 不是交易结果。 缩尾后次月收益上的预测 R^2 不是组合收益,也没有考虑交易成本和约束(附录 I.3,第 60 页)。
- 不是独立证据。 九次年度选择和 24 个相互重叠的检验设定只是敏感性汇总,既不是独立重复,也不是置信区间(第 12 页;附录 I.2,第 59 页)。
- 不涵盖所有阿尔法。 研究对象是由特征生成的阿尔法成分,而不是每只股票层面的全部定价误差(第 5 页)。
- 探索性的历史证据。 这段历史样本已经影响了研究设计;原始数据的版本差异和退市处理,也尚未完全核清(第 10 页;附录 I.3,第 60 页)。
参考文献
Choi, Jungjun, and Ming Yuan. 2025. Inferential Theory for Pricing Errors with Latent Factors and Firm Characteristics. arXiv preprint 2511.03076. https://arxiv.org/abs/2511.03076.
Jensen, Theis Ingerslev, Bryan Kelly, and Lasse Heje Pedersen. 2023. “Is There a Replication Crisis in Finance?” Journal of Finance 78 (5): 2465–518. https://doi.org/10.1111/jofi.13249.
Kelly, Bryan T., Seth Pruitt, and Yinan Su. 2019. “Characteristics Are Covariances: A Unified Model of Risk and Return.” Journal of Financial Economics 134 (3): 501–24. https://doi.org/10.1016/j.jfineco.2019.05.001.
Kozak, Serhiy, Stefan Nagel, and Shrihari Santosh. 2020. “Shrinking the Cross-Section.” Journal of Financial Economics 135 (2): 271–92. https://doi.org/10.1016/j.jfineco.2019.06.008.
Liu, Mingyang. 2026. Characteristic-Space Metrics in Factor Models: Identification and Inference. SSRN preprint. https://doi.org/10.2139/ssrn.7445120.
Zhang, Chu. 2024. “Testing Pricing Errors of Models with Latent Factors and Firm Characteristics as Covariances.” Management Science 70 (3): 1706–28. https://doi.org/10.1287/mnsc.2023.4768.
引用
BibTeX
@report{liu2026errors,
  author = {Liu, Mingyang},
  publisher = {Imperial Business School, Imperial College London},
  title = {Interpreting Estimated Pricing Errors: Evidence from
    Characteristic-Based Return Forecasts},
  date = {2026-09},
  url = {https://yl7919.github.io/zh/research/interpreting-pricing-errors.html},
  langid = {zh}
}
请按如下格式引用:
Liu, Mingyang. 2026. Interpreting Estimated Pricing Errors: Evidence
from Characteristic-Based Return Forecasts. Working paper. Imperial
Business School, Imperial College London. https://yl7919.github.io/zh/research/interpreting-pricing-errors.html.