palette = ({
  naipca_iab: "#18557f", complete: "#18557f",
  qz_ipca: "#8a6a1a",
  ipca: "#6f9cc0", rp_pca: "#7a7a7a", ff5: "#b3b3b3",
  naipca_beta_only: "#8a8378", beta_only: "#8a8378",
  band: "rgba(0,0,0,0.06)", muted: "rgba(0,0,0,0.6)", rule: "rgba(0,0,0,0.1)"
})
LANG = (document.documentElement.lang || "en").startsWith("zh") ? "zh" : "en"
STR = ({ en: { view: "View", cost: "Cost (bp per traded dollar)", universe: "Universe", sample: "Sample (months)", log: "Log scale", models: "Models", statistic: "Statistic", theme: "Theme", sort: "Sort by", method: "Method", scenario: "Scenario", block: "Block (months)", metric: "Metric", intervals: "Intervals", cost_bp: "One-way cost (bp)", failed: "Interactive data failed to load. The static figure is shown instead." },
        zh: { view: "视图", cost: "成本(每交易一美元,基点)", universe: "股票池", sample: "样本(月)", log: "对数坐标", models: "模型", statistic: "统计量", theme: "主题", sort: "排序", method: "方法", scenario: "情景", block: "块长(月)", metric: "指标", intervals: "区间", cost_bp: "单边成本(基点)", failed: "交互数据加载失败,改为显示静态图。" } })
t = (k) => STR[LANG][k] ?? STR.en[k] ?? k
fmt2 = (x) => (x == null || Number.isNaN(x)) ? "n/a" : x.toFixed(2)
fmt1 = (x) => (x == null || Number.isNaN(x)) ? "n/a" : x.toFixed(1)
fmtBp = (x) => (x == null || Number.isNaN(x)) ? "> 500" : `${Math.round(x)} bp`
parseMonth = (s) => new Date(`${s}-01T00:00:00Z`)
// Sharpe, annualised, sample std (ddof = 1): matches the release convention
sharpe = (r) => {
  const n = r.length, m = r.reduce((a, b) => a + b, 0) / n
  const v = r.reduce((a, b) => a + (b - m) ** 2, 0) / (n - 1)
  const vol = Math.sqrt(v) * Math.sqrt(12)
  return vol > 1e-12 ? (m * 12) / vol : NaN
}
netSeries = (r, to, bp) => r.map((x, i) => x - to[i] * bp / 1e4)
wealthPath = (r) => { let w = 1; return r.map((x) => (w *= 1 + x)) }
nberMarks = (nber) => Plot.rectX(nber, { x1: (d) => parseMonth(d.start), x2: (d) => parseMonth(d.end), fill: palette.band })基于特征的因子模型中识别问题的几何框架
A Geometric Framework for Identification in Characteristic-Based Factor Models
因子模型该用哪把尺子,来判断两个特征方向是否不同?
SSRN 预印本,2026 年 3 月(初步版本)· DOI 10.2139/ssrn.7013178(SSRN 署名为 Yang Liu)· 《特征空间度量》的早期版本,覆盖范围更宽 · 源自博士论文
投资者往往用几十个特征来描述一只股票,其中许多彼此近乎重复。模型要说清哪些特征组合获得风险补偿,先得判断两个特征组合是否真的不同,而做这个判断需要一把尺子。本文从数据中估计这把尺子,称为特征尺子(格拉姆度量):它记录特征在股票之间如何分散、又如何彼此重叠。本文以特征尺子为基础重建工具化主成分分析(IPCA),得到无套利 IPCA(NA-IPCA)。检验采用按美国股票校准的模拟,真实定价方向按设计落在特征变动最大的那些方向上。估计方向与真实方向的差距用子空间距离衡量:0 表示完全找回,约 1.73 表示方向完全错误。NA-IPCA 的距离为 0.01,几乎完全找回了这些方向;不含截距块(即不为因子未能解释的预期收益留位置)的 IPCA 基准则为 0.73(表 8,第 38 页)。模拟收益中含有截距成分,而这一基准没有截距块,所以两者的比较没有把尺子的作用单独分离出来。
1 研究问题
在整个研究主线中,本文回答的是第一个问题:用哪把尺子?下一篇《特征空间度量》接着问:尺子选定之后,它究竟决定了什么?又能决定得多精确?
公司特征彼此重叠、离散程度又各不相同。哪些特征方向才是真正不同、且获得风险补偿的来源,哪些只是近似重复或剩余部分?
要说清一只股票的预期收益中各个驱动因素分别解释了多少,模型得先判断两个特征组合是否真的不同、各自有多大。做这个判断的规则,就是尺子。给每个特征一个权重再相加,每只股票就得到一个分数;这样的加权组合称为特征方向(它不是投资组合)。普通尺子(欧氏度量,即单位矩阵度量)只看方向的权重本身;特征尺子(格拉姆度量)则看这个方向给真实股票打出的分数:分数通常有多大,两个方向的分数在股票之间是否同高同低。
所以,尺子就是模型用来衡量一个特征方向有多大、两个特征方向重叠多少的规则。两个价值信号若总是选中同一批便宜的股票,特征尺子会把它们算作重叠,普通尺子却把它们当作互不相关。
常用的标准方法,如主成分分析(PCA)、IPCA (Kelly 等 2019) 以及许多用机器学习估计随机贴现因子的方法,都默认每个特征尺度相同、彼此无关,也就是用普通尺子(单位矩阵度量)(第 1.1 节,第 2 页)。其中,IPCA 以特征作为工具变量,决定每只股票在共同驱动因素上的载荷(贝塔)。
模型分三块:潜在因子(模型从数据中推断的共同驱动因素)、市场等可观测因子,以及截距。截距是本模型中没有被任何因子解释的那部分预期收益(与首页所说的“阿尔法”相近,但阿尔法是相对于某个指定基准模型而言的)。
一句话回答。 用特征尺子(格拉姆度量)来衡量:这把尺子取自特征在股票之间的离散与重叠。在按美国股票校准、真实定价方向按设计落在特征变动最大的那些方向上的模拟中,基于它的估计量 NA-IPCA 找回了这些方向,不含截距块的 IPCA 基准则没有。
2 为什么重要
尺子决定了什么算“不同”。用普通尺子(单位矩阵度量),模型可能把一个定价方向拆成两个因子,让潜在因子复制模型中已有的可观测基准因子,或把定价内容推给截距(第 1.1 节,第 2–3 页)。
- 实务含义。 本文认为,特征尺子能防止潜在因子沦为基准组合的翻版。这样,投资组合经理等使用者就能更清楚地分辨三样东西:被定价的结构、基准因子暴露(暴露即股票在某个特征方向上的得分,或随某个因子变动的强弱)与残余噪声(第 1.4–1.5 节,第 5–6 页)。这一点来自论证和模拟,并未在实盘组合上得到检验。
- 统计含义。 拟合好不等于结构对:在论文的度量扫描中(见下文表 1),IPCA 的样本内 R² 高于 NA-IPCA,却没有找回真实方向(表 9,第 42 页)。
3 论证脉络
- 问题。 股票由几十个特征刻画,其中许多只是少数几种特质的不同版本(第 6.2 节,第 28 页)。→ 研究问题
- 动机。 正因为特征彼此重叠,PCA 和 IPCA 所用的普通尺子(单位矩阵度量)会误判哪些特征组合真正不同(第 1.1 节,第 2 页)。→ 为什么重要
- 框架。 从数据中估计特征尺子(格拉姆度量 Q_Z),并在这把尺子下写出模型的全部约束,包括把三块分开的识别约束,以及截距可承载多少的上限,由此得到 NA-IPCA。→ 理论框架
- 机制。 在普通尺子下正交(看似互不相关)的两个方向,在特征尺子下可能彼此重叠;所以在特征尺子下对各块做正交化,同一部分就不会被重复计算。→ 一个简单例子
- 证据。 美国股票的特征尺子高度不均匀。在主模拟中,NA-IPCA 找回了定价方向,不含截距块的 IPCA 基准则没有;由于这一基准缺少截距块,这一比较没有把尺子的作用单独分离出来。在压力测试设计中,IPCA 也接近真实方向(相距 0.01–0.06,表 17–19)。在度量扫描(见下文表 1)和相关性扫描中则不然:后者让特征从彼此无关逐步接近美国数据的相关结构(表 10,第 43 页),IPCA 与真值的距离都在 0.73–0.99 之间。→ 研究设计与主要结果
- 贡献。 尺子成为模型经济含义的一部分,需要明确写出、从数据估计。→ 与既有文献的比较
- 边界。 本文没有在真实收益或组合上检验 NA-IPCA,真实数据的应用留给另一项研究(第 50–51 页)。→ 适用范围
4 理论框架
设 Z_t 为第 t 月 N_t 只股票的 L 个特征。特征尺子(格拉姆度量),就是特征横截面二阶矩矩阵的长期平均,刻画特征在股票之间的离散与共同变动(第 2 节,第 6 页):
Q_Z = \frac{1}{T}\sum_{t=1}^{T} \frac{1}{N_t} Z_t^{\top} Z_t .
用这把尺子量,权重为 a 的方向大小(范数)为 (a^{\top} Q_Z a)^{1/2},大致反映它给各只股票打出的分数高低相差多大。普通尺子则把 Q_Z 换成单位矩阵。
条件预期超额收益分为三块(第 2 节,第 7 页):
\mathbb{E}_t\!\left[r_{t+1}\right] = Z_t\left(\Gamma_\beta f_t + \Gamma_\delta F^{\text{obs}}_t + \Gamma_\alpha\right).
\Gamma_\beta 是潜在因子 f_t 的载荷矩阵(载荷即股票随某个因子变动的强弱),\Gamma_\delta 是可观测因子(如可交易的基准因子)的载荷矩阵,\Gamma_\alpha 是由特征构成的截距(表 1,第 7 页)。本文的估计量无套利 IPCA(NA-IPCA)用 Q_Z 写出三块的全部规则,并为截距可承载的预期收益设上限。名称中的“无套利”即指这一上限:上限越紧,模型越接近严格无套利(第 2 节,第 8 页)。换成普通尺子、截距上限始终不起作用(约束松弛)时,NA-IPCA 退化为 IPCA(第 22 页)。
供专业读者:约束、估计量与推断
在 Q_Z 下,潜在因子载荷标准正交(\Gamma_\beta^{\top} Q_Z \Gamma_\beta = I);可观测因子块与截距块都与潜在子空间 Q_Z-正交;截距的大小受上限约束,\psi(\Gamma_\alpha) = \Gamma_\alpha^{\top} Q_Z \Gamma_\alpha \le \delta(第 2 节,第 7–8 页)。NA-IPCA 就是在这一约束集上求解的加权最小二乘估计(命题 3.1,第 14 页);本文还给出了已识别子空间的旋转不变渐近推断(第 4 节,第 17 页起)。
5 一个简单例子
设有两个特征 A 与 B,比如两种价值指标,它们在股票之间的相关系数为 ρ。定价方向对二者的权重相同。假设模型把 A 放进一块、把 B 放进另一块。用普通尺子(单位矩阵度量)量,A 与 B 正交、看似互不相关,于是两块都把共同的部分算作自己的。
试一试。(1)把 ρ 调到 0,两种分块合计都是 100%。(2)把 ρ 调到 0.9,用普通尺子分块,两块合计声称解释 190%。请注意:用特征尺子分块时,合计始终为 100%,因为 B 块对 A 块做了正交化,只保留 A 块未能解释的部分,重叠部分只算一次。
图 1:两个相关特征下的两把尺子。示意数字,并非论文数据。
怎么读。左图:金色箭头是 A、B 两个方向的权重,深色箭头是定价方向。大小为 1 的方向,用普通尺子量落在虚线圆上,用特征尺子量落在蓝色椭圆 a^{\top} Q a = 1 上(Q 的对角元为 1、非对角元为 ρ)。右图:两行都用特征尺子计分(方向只经由股票得分影响收益),显示各块解释的定价方向占比:A 或 B 单独解释 (1+\rho)/2,剔除与 A 重叠的部分后,B 解释 (1-\rho)/2。示例中的 ρ 是两个特征之间的相关系数,不是论文相关性扫描中的权重 ρ(表 10,第 43 页)。来源:基于论文定义(第 2 节;图 3,第 34 页)的示意计算,无数据文件。
6 研究设计与主要结果
论文先在 Kelly 等 (2019) 的复现数据上估计特征尺子:37 个特征(含常数项)、12,813 家公司,样本期为 1964 年 7 月至 2014 年 5 月(第 6.1 节,第 27 页;表 2,第 28 页)。随后模拟 1,000 只股票、240 个月的面板,进行 300 次蒙特卡洛重复,特征按这把尺子生成。按设计,三个潜在因子放在特征变动最大的方向上,两个可观测因子刻意设弱,收益中还含有一个非零截距成分(第 7.1 节,第 34–36 页;表 7,第 36 页)。在同一组模拟数据上,比较三个估计量:NA-IPCA、不含截距块的 IPCA 基准与 PCA(第 7.2 节,第 36 页)。
图 2:特征尺子高度不均匀。Q_Z 最大的 15 个特征值(主方向)各自在总离散度(Q_Z 的迹)中所占的比例。
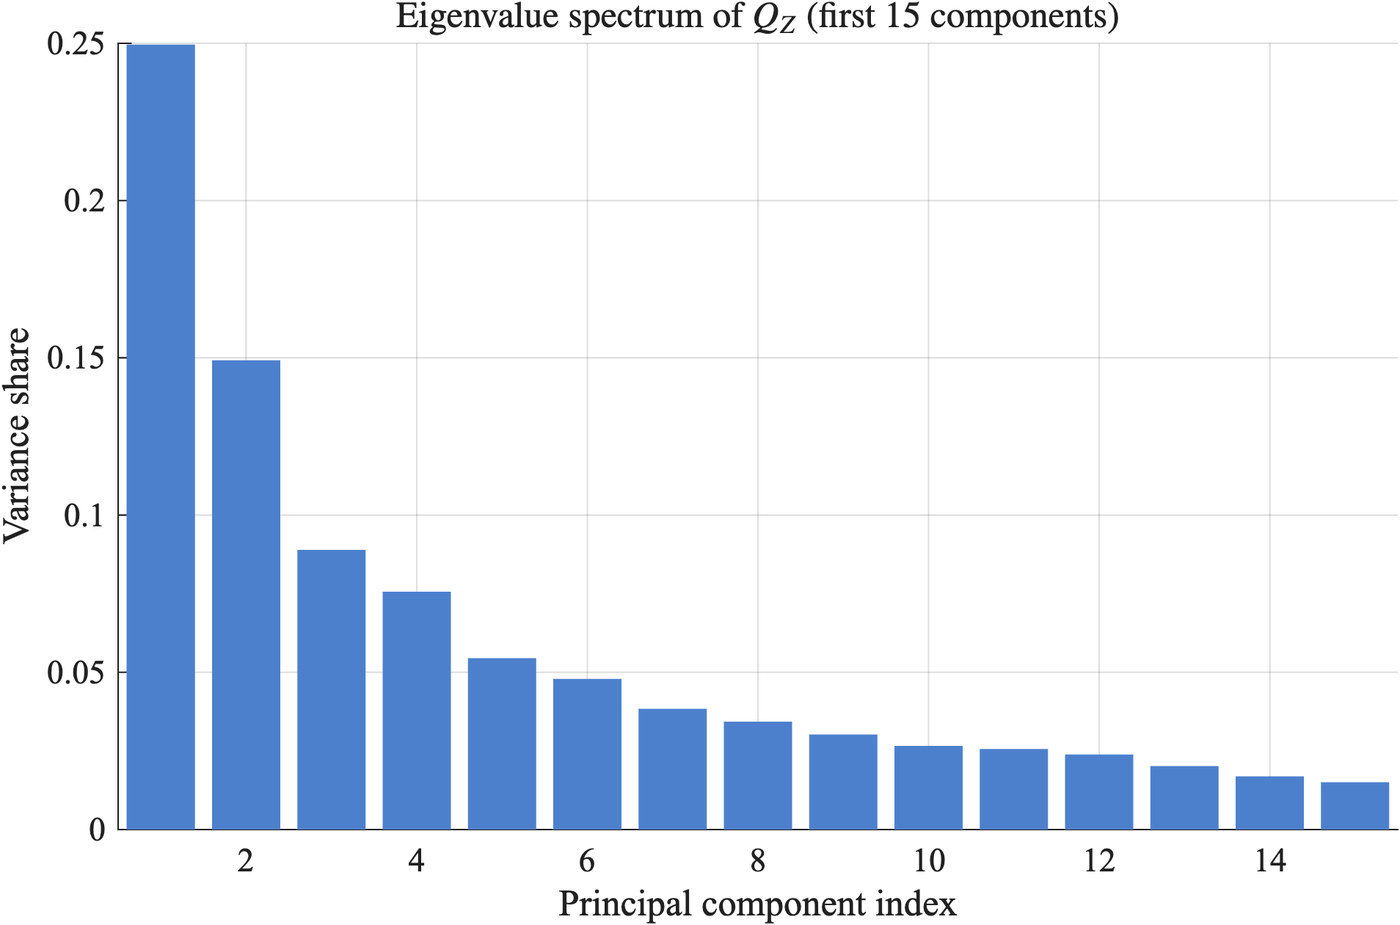
这说明什么。 37 列中有一列是常数(表 6,第 32 页)。这一列在 Q_Z 中的对角元为 1,它在全部对角元之和(即迹)4.01 中所占的份额,与 Q_Z 最大特征值(eigenvalue)所占的份额相当(表 7,第 36 页);所以,约占 25% 的第一根柱,基本上就是这个常数。不均匀体现在其余部分:若其余 36 个特征彼此无关、离散程度相同(普通尺子正是这样假定的),每个方向约占 2%;实际上,接下来的四个方向合计就占约 37%(表 5,第 30 页)。这描述的是特征如何重叠,而不是哪些方向被定价。
图 3:在主模拟设计中,NA-IPCA 找到了真实的潜在子空间,不含截距块的 IPCA 与 PCA 则没有。估计的因子方向(即“子空间”)与真实方向之间的子空间距离。
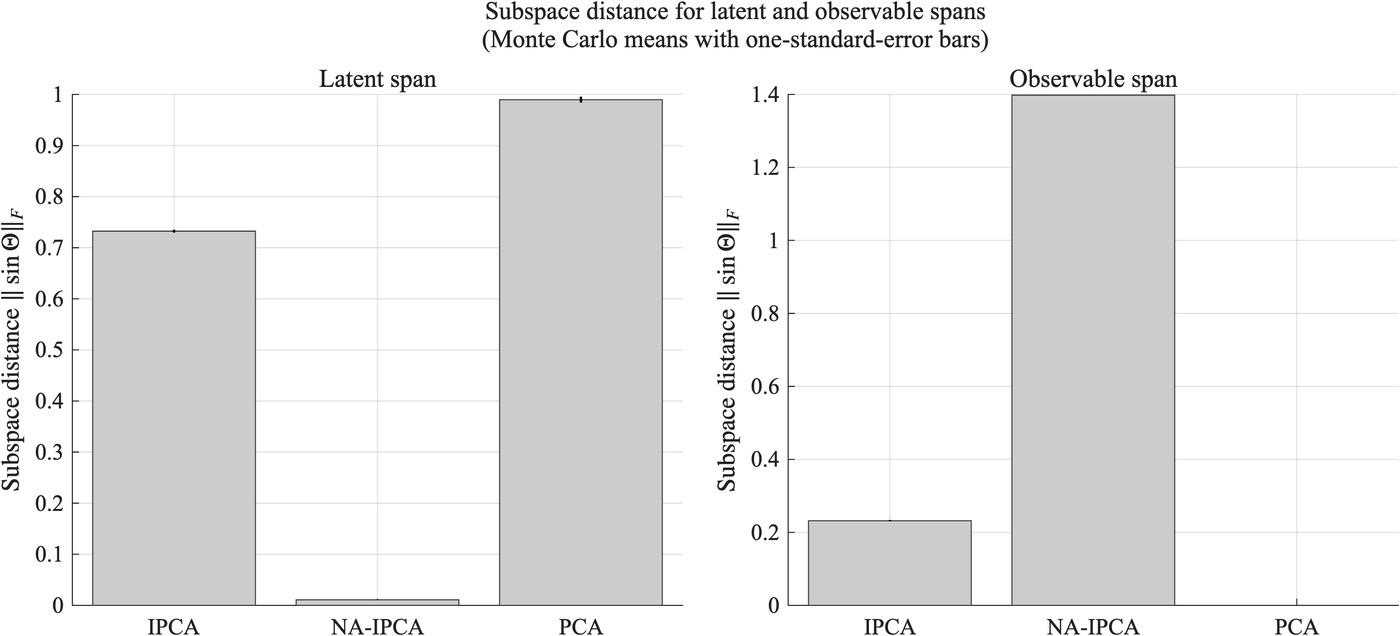
怎么读。左图(Latent span)为潜在因子方向,右图(Observable span)为可观测因子方向。距离 \lVert \sin\Theta \rVert_F 在完全找回时为 0,方向完全错误时达到最大值:三个潜在因子方向为 \sqrt{3} \approx 1.73,两个可观测因子方向为 \sqrt{2} \approx 1.41(脚注 10,第 39 页)。在可观测因子块上排序反转:IPCA 0.23,NA-IPCA 1.40,接近最大值,即 NA-IPCA 没有找回可观测方向。PCA 没有可观测因子块,所以右图中 PCA 一栏空缺,表示无定义,而不是 0。本文认为这源于设计:可观测因子刻意设得很弱(第 7.2 节,第 37 页)。来源:SSRN 预印本,2026 年 3 月,图 4,第 39 页;表 8,第 38 页(转载自论文)。 论文原页
这说明什么。 距离尺度为 0 到约 1.73。真实定价方向按设计落在特征变动最大的方向上时,NA-IPCA 估出的潜在因子方向与真值相距 0.011;不含截距块的 IPCA 基准相距 0.73,PCA 为 0.99(表 8,第 38 页)。以重叠度衡量(0 表示两块完全分开),IPCA 基准的潜在因子块与可观测因子块重叠 0.069;NA-IPCA 按构造把两块分开,仅为 0.0005。简单例子中的重复计算,在这里以较轻的形式出现。
表 1:只改变特征的分布(论文的度量扫描)。真实载荷与因子保持不变,特征采用四种抽样方式;数值为 300 次蒙特卡洛重复的均值(表 9,第 42 页)。
| 特征几何 | 潜在距离 IPCA |
潜在距离 NA‑IPCA |
重叠度 IPCA |
重叠度 NA‑IPCA |
样本内 R² IPCA |
样本内 R² NA‑IPCA |
|---|---|---|---|---|---|---|
| 经验 Q_Z | 0.7325 | 0.0112 | 0.0663 | 0.0005 | 0.9588 | 0.5827 |
| 单位矩阵 | 0.9843 | 0.0075 | 0.0463 | 0.0008 | 0.9449 | 0.1601 |
| Q_Z,特征向量置换 | 0.9907 | 0.0387 | 0.0401 | 0.0017 | 0.9885 | −0.0735 |
| Q_Z,特征值拉平 | 0.9831 | 0.0073 | 0.0466 | 0.0008 | 0.9453 | 0.1579 |
潜在距离:潜在因子方向的 \lVert \sin\Theta_\beta \rVert_F,取值 0 至约 1.73。重叠度:在 Q_Z 下潜在因子块与可观测因子块的重叠。R²:收益的样本内面板 R²。此处“特征值”“特征向量”指矩阵 Q_Z 的 eigenvalue 与 eigenvector,与公司特征无关。来源:SSRN 预印本,2026 年 3 月,表 9,第 42 页。
这说明什么。 每一行的真实方向都按设计落在美国数据中特征变动最大的方向上(第 7.3 节,第 38 页)。IPCA 基准与真值的距离始终在 0.73–0.99 之间;NA-IPCA 都不超过 0.04。在“单位矩阵”和“特征值拉平”两行中,特征按彼此无关、离散程度相同的方式抽取,所以特征尺子(格拉姆度量)与普通尺子(单位矩阵度量)只差一个常数倍(脚注 9,第 38–39 页)。即便如此,IPCA 基准与 NA-IPCA 离真值的远近依然相差同样大;可见这一差距并非来自特征分布的不均匀。IPCA 在每一行的样本内 R² 仍然更高,为 0.94–0.99,NA-IPCA 最高只有 0.58(表 9,第 42 页)。在论文的压力测试设计中,截距成分的大小约为 0.05,主模拟则为 0.50。在这些设计中,IPCA 接近真实方向,相距 0.01–0.06(表 17–19,第 63–64 页)。
7 与既有文献的比较
下表列出最接近的参照(第 1.2 节,第 3–4 页)。
| 既有研究 | 已确立的结论 | 本文的推进 |
|---|---|---|
| 近似因子模型 (Bai and Ng 2002) | 在弱相关条件下,确定大面板中公因子的个数 | 在因子个数给定之后,追问哪些方向被定价,并用估计出的尺子来衡量 |
| IPCA (Kelly 等 2019) | 以特征作为工具变量,刻画随时间变化的贝塔(β);模型可包含截距与可观测因子,并检验二者是否为零 | 在特征尺子(格拉姆度量)下设定模型的标准化与分块,并为截距可承载的内容设上限 |
| 风险溢价主成分分析(RP-PCA)(Lettau and Pelger 2020) | 在 PCA 中加入定价误差惩罚,使因子同时拟合平均收益 | 借助尺子与截距上限,直接限定哪些模型可以接受,以此施加定价约束 |
| 收缩横截面 (Kozak 等 2020) | 以先验收缩随机贴现因子在特征投资组合上的系数,对低方差主成分收缩最强 | 不把特征尺子用作惩罚项,而是用它设定模型的尺度、把各块分开 |
模拟中的弱可观测因子借鉴了弱因子与伪因子方面的研究 (Bryzgalova 2015; Kozak 等 2018)(第 32 页);截距上限则与波动率界 (Hansen and Jagannathan 1991) 相关(第 10 页)。
许多既有研究先用固定的尺子提取因子,再在此基础上施加定价约束(第 1.2 节,第 4 页);本文则把尺子本身当作需要估计的对象。所依据的工具早已为人所知;本文的新意在于,以这把估计出来的尺子为基础,构建估计量并给出推断。
在研究主线的各篇论文中,本文最早提出贯穿始终的想法:尺子从数据中取得,模型的各项约束都在这把尺子下设定。《特征空间度量》把尺子的作用讲得更精确:尺子决定拆分,不决定拟合;尺子本身的估计误差也应计入标准误。《解读定价误差》固定尺子,公平地解读阿尔法。《预测相同,组合不同》在 NA-IPCA 处引用本文(脚注 3,第 10 页),并表明即使预测几乎不变,尺子的单位也能改变组合;《尺子很重要》直接在股票上计量这把尺子,追问模型的因子代表了哪些头寸,以及对冲这些头寸需要什么。
8 适用范围
- 本文没有在真实收益或组合上检验 NA-IPCA。在模拟中,NA-IPCA 与 IPCA 的样本外收益 R² 相同(表 19,第 64 页);在美国股票上做完整的样本外应用,留待另一项研究(第 8 节,第 50–51 页)。
- 模拟中,真实定价方向按设计落在特征变动最大的方向上;模拟收益含有截距成分,IPCA 基准却没有截距块(第 7.1–7.2 节,第 34–36 页)。因此,这一比较没有把尺子的作用单独分离出来,也不能说明真实市场遵循哪把尺子。
- 特征尺子(格拉姆度量 Q_Z)是根据单一样本(1964 至 2014 年)估计的;若特征分布发生变化,应重新估计尺子(第 8 节,第 50 页)。
- 截距是因子未能解释、且设有上限的那部分预期收益,并非实测的错误定价。
- 大样本理论只在文中列明的条件下成立。本文的效率结论是局部的:在满足本文约束的估计量中,NA-IPCA 达到效率界(efficiency bound)(第 4.3 节,第 19 页);本文并未声称 NA-IPCA 在一般意义上是最优的估计量。
参考文献
Bai, Jushan, and Serena Ng. 2002. “Determining the Number of Factors in Approximate Factor Models.” Econometrica 70 (1): 191–221. https://doi.org/10.1111/1468-0262.00273.
Bryzgalova, Svetlana. 2015. “Spurious Factors in Linear Asset Pricing Models.” Working paper. https://sabryzgalova.com/research/.
Hansen, Lars Peter, and Ravi Jagannathan. 1991. “Implications of Security Market Data for Models of Dynamic Economies.” Journal of Political Economy 99 (2): 225–62. https://doi.org/10.1086/261749.
Kelly, Bryan T., Seth Pruitt, and Yinan Su. 2019. “Characteristics Are Covariances: A Unified Model of Risk and Return.” Journal of Financial Economics 134 (3): 501–24. https://doi.org/10.1016/j.jfineco.2019.05.001.
Kozak, Serhiy, Stefan Nagel, and Shrihari Santosh. 2018. “Interpreting Factor Models.” Journal of Finance 73 (3): 1183–223. https://doi.org/10.1111/jofi.12612.
Kozak, Serhiy, Stefan Nagel, and Shrihari Santosh. 2020. “Shrinking the Cross-Section.” Journal of Financial Economics 135 (2): 271–92. https://doi.org/10.1016/j.jfineco.2019.06.008.
Lettau, Martin, and Markus Pelger. 2020. “Factors That Fit the Time Series and Cross-Section of Stock Returns.” Review of Financial Studies 33 (5): 2274–325. https://doi.org/10.1093/rfs/hhaa020.
引用
BibTeX
@report{liu2026framework,
  author = {Liu, Mingyang},
  title = {A Geometric Framework for Identification in
    Characteristic-Based Factor Models},
  date = {2026-03},
  url = {https://mingyangliu.org/zh/research/geometric-framework.html},
  doi = {10.2139/ssrn.7013178},
  langid = {zh}
}
请按如下格式引用:
Liu, Mingyang. 2026. A Geometric Framework for Identification in
Characteristic-Based Factor Models. SSRN preprint. https://doi.org/10.2139/ssrn.7013178.