palette = ({
  naipca_iab: "#18557f", complete: "#18557f",
  qz_ipca: "#8a6a1a",
  ipca: "#6f9cc0", rp_pca: "#7a7a7a", ff5: "#b3b3b3",
  naipca_beta_only: "#8a8378", beta_only: "#8a8378",
  band: "rgba(0,0,0,0.06)", muted: "rgba(0,0,0,0.6)", rule: "rgba(0,0,0,0.1)"
})
LANG = (document.documentElement.lang || "en").startsWith("zh") ? "zh" : "en"
STR = ({ en: { view: "View", cost: "Cost (bp per traded dollar)", universe: "Universe", sample: "Sample (months)", log: "Log scale", models: "Models", statistic: "Statistic", theme: "Theme", sort: "Sort by", method: "Method", scenario: "Scenario", block: "Block (months)", metric: "Metric", intervals: "Intervals", cost_bp: "One-way cost (bp)", failed: "Interactive data failed to load. The static figure is shown instead." },
        zh: { view: "视图", cost: "成本(每交易一美元,基点)", universe: "股票池", sample: "样本(月)", log: "对数坐标", models: "模型", statistic: "统计量", theme: "主题", sort: "排序", method: "方法", scenario: "情景", block: "块长(月)", metric: "指标", intervals: "区间", cost_bp: "单边成本(基点)", failed: "交互数据加载失败,改为显示静态图。" } })
t = (k) => STR[LANG][k] ?? STR.en[k] ?? k
fmt2 = (x) => (x == null || Number.isNaN(x)) ? "n/a" : x.toFixed(2)
fmt1 = (x) => (x == null || Number.isNaN(x)) ? "n/a" : x.toFixed(1)
fmtBp = (x) => (x == null || Number.isNaN(x)) ? "> 500" : `${Math.round(x)} bp`
parseMonth = (s) => new Date(`${s}-01T00:00:00Z`)
// Sharpe, annualised, sample std (ddof = 1): matches the release convention
sharpe = (r) => {
  const n = r.length, m = r.reduce((a, b) => a + b, 0) / n
  const v = r.reduce((a, b) => a + (b - m) ** 2, 0) / (n - 1)
  const vol = Math.sqrt(v) * Math.sqrt(12)
  return vol > 1e-12 ? (m * 12) / vol : NaN
}
netSeries = (r, to, bp) => r.map((x, i) => x - to[i] * bp / 1e4)
wealthPath = (r) => { let w = 1; return r.map((x) => (w *= 1 + x)) }
nberMarks = (nber) => Plot.rectX(nber, { x1: (d) => parseMonth(d.start), x2: (d) => parseMonth(d.end), fill: palette.band })预测相同,组合不同:因子标准化与正则化
Same Forecasts, Different Portfolios: Factor Normalization and Regularization
同一个因子模型的两个版本预测相同;当因子暴露上的惩罚写在各自的单位里时,它们为什么会持有不同的投资组合?用上模型本来就估计出的截距,又能多带来什么?
工作论文,2026 年 10 月 · 共 116 页(英文):正文 46 页,网络附录 70 页(页码记为 IA-1 至 IA-70)· 尚未在 SSRN 发布,暂无 DOI · 页码均指上方论文
同一个因子模型的两个版本,可以给出相同的股票收益预测,却持有不同的投资组合。原因在于组合规则给每个因子的方差都加上一个小常数(岭项,论文称之为因子惩罚):它按组合在每个因子上押注多少收费,而押注的多少按各版本各自采用的单位计量,于是同一个数就成了两种不同的惩罚(式 6,第 11 页)。在 594 个月中,两个版本的股票预测相对差距的中位数只有百万分之 4.8(表 II,第 24 页)。然而在同一个惩罚数值下,它们未计交易成本的夏普比率(每单位波动获得的平均超额收益)分别为 0.69 和 1.07(表 I,第 19 页)。把惩罚写在同一套单位里,就只剩一个组合;去掉惩罚,两个版本的夏普比率都是 1.62。
构建组合既需要风险惩罚,也需要收益预测;第二项结果转向收益预测。同类模型还可以估计截距,即预期收益中没有被任何因子解释的那部分。使用包含截距的完整拟合均值,所得组合未计交易成本的夏普比率为 2.51,几乎不随惩罚变化。它相对不含截距的最佳组合的增益为 0.89,95% 区间为 [0.59, 1.26];按每交易一美元收取 25 个基点扣除成本后,增益为 0.57 [0.29, 0.89](表 III,第 30 页)。2007 年 10 月以来,扣除成本后的优势,其区间包含零(第 7、39 页)。
1 研究问题
在整个研究主线中,本文追问的是:预测相同,组合为何不同?《解读定价误差》追问模型的阿尔法意味着什么;本文则从解读模型转向依据模型行动。随后,《尺子很重要》固定目标再追问:目标相同,持仓为何不同?
同一个因子模型的两个版本预测相同,只是用不同的尺子衡量因子暴露,它们会让投资者持有同样的股票吗?把模型本来就估计出的截距也用上,又能多带来什么?
要说清一只股票的预期收益有多少归功于哪个驱动因素,模型得先判断两个特征方向是否真的不同、各自有多大。做这个判断的规则,就是尺子;严格地说,即特征空间上的一种度量(内积)。给每个特征一个权重再相加,每只股票就得到一个分数;这样的加权组合称为特征方向(它不是投资组合)。股票在某个特征方向上的得分,或随某个因子变动的强弱,就是它的暴露。普通尺子(欧氏度量)只看方向的权重本身;特征尺子(格拉姆度量,由特征的格拉姆矩阵构造,即各特征两两乘积在股票之间的平均)则看这个方向给真实股票打出的分数:分数通常有多大,两个方向的分数在股票之间是否同高同低。换句话说,尺子是模型用来衡量一个特征方向有多大、两个特征方向重叠多少的规则。两个价值信号若总是选中同一批便宜的股票,特征尺子会把它们算作重叠,普通尺子却把它们当作互不相关。
本文比较同一因子模型分别估计的两个版本,它们只在尺子上不同。工具化主成分分析(IPCA)是一种标准的条件因子模型,由特征决定每只股票的因子载荷,即股票随共同驱动因素变动的强弱 (Kelly 等 2019)。它的潜在因子(模型从数据中推断的共同驱动因素)没有天然的单位,模型必须把单位定下来,论文称这一选择为标准化(normalization)。用普通尺子来定,就是欧氏标准化,也就是 IPCA 的常用约束;用特征尺子来定,就是格拉姆标准化,所用的正是《特征空间度量》的度量 (Liu 2026b)(式 2–3 与脚注 3,第 10 页)。第三个拟合还加入了截距:本模型中没有被任何因子解释的那部分预期收益(与首页所说的“阿尔法”相近,但阿尔法是相对于某个指定基准模型而言的)。它就是《几何框架》中的无套利 IPCA(NA-IPCA)(Liu 2026a),名称中的“无套利”指截距可承载内容的上限;在本文的每个日期,这一上限都不起作用(脚注 3,第 10 页)。
2 为什么重要
比较因子模型时,人们常看各自组合的夏普比率;但组合是预测经过风险矩阵加工的结果,而风险矩阵里的设定写在模型自己的单位里。如果某项设定本身就能改变持仓,基金经理换用或重新估计风险模型、看到新的头寸,就可能误以为出现了新信号,其实预测并没有变。
- 经济含义。 同一个惩罚数值,会左右不同模型族之间的比较。在参考惩罚下,风险溢价主成分分析(RP-PCA,另一种提取因子的方法)未计交易成本的夏普比率为 1.49,普通尺子下的 IPCA 为 0.69。去掉惩罚,0.80 的差距变为 −0.08,区间为 [−0.44, 0.26](表 I,第 19 页;表 II,第 24 页)。
- 实务含义。 为数值稳定而加在因子方差上的常数,其实是对因子暴露的惩罚。把它写在同一套单位里,或者直接写在个股头寸上,换一种标准化就不会改变组合(命题 1,第 12 页)。论文给出的设计准则是:写明惩罚、惩罚所用的单位,以及组合用了拟合均值的哪一部分(第 43 页)。
- 统计含义。 参考惩罚约为普通尺子单位下因子方差中位数的 11 倍、特征尺子单位下的 27 倍。不加惩罚,因子协方差矩阵本来就可逆(最小特征值 3.1 × 10⁻⁵),所以这个常数并非为可逆性所必需(网络附录 IA.E.2,第 IA-22 页)。
3 论证脉络
- 问题。 投资者持有的是组合而不是预测,所以比较模型必须一直追到持仓。→ 研究问题
- 框架。 潜在因子的单位只是一种约定:把某个因子放大一倍、载荷减半,每个拟合收益都不变(第 11 页)。分别估计的两个版本预测几乎相同,相对差距的中位数为百万分之 4.8。→ 理论框架
- 机制。 规则加在因子方差上的常数,按各版本自己的单位对因子暴露收费,同一个数压低的就是不同的个股头寸。→ 一个简单例子
- 证据。 在参考惩罚下,两个版本持有不同的股票,未计交易成本的夏普比率分别为 0.69 和 1.07。→ 图 2
- 补救。 把惩罚写在同一套单位里,就只剩一个组合(“1 减权重相似度”的月度中位数为 1.0 × 10⁻¹¹);去掉惩罚,两个版本都是 1.62(未计交易成本)。→ 表 1
- 第二项结果。 在同一个拟合内使用含截距的完整拟合均值,未计交易成本的夏普比率为 2.51,几乎不随惩罚变化,比不含截距的最佳组合高 0.89。→ 图 3
- 边界。 写明惩罚、惩罚的单位和所用的均值输入。边界是:除非另有说明,收益未计交易成本;成本按比例计算;未证明截距是错误定价;2007 年以后扣除成本后的优势尚无定论;也没有证明哪把尺子或哪种惩罚强度最好。→ 适用范围
4 理论框架
组合规则在某个因子的预测相对其估计风险较高时,就多持有这个因子。在对因子风险求逆之前,它给每个因子的方差加上一个小常数(0.01,即岭项:为数值稳定加在因子风险上的小常数,论文称之为因子惩罚),让规则对每个因子都少持有一点。这个常数按因子载荷报告时所用的单位,对组合在每个因子上的暴露收费;所以换尺子,就改变了每个个股头寸被压低的程度(式 6,第 11 页)。
换尺子是一次匹配的单位换算:每个拟合收益和残差都不变,载荷被重新缩放,重叠部分则在潜在因子、法玛–弗伦奇可观测因子与截距之间挪动(命题 1,第 12 页)。在组合规则的各项输入中,只有惩罚会变:把某个因子放大一倍、载荷减半,同一个惩罚落在这个因子上就只剩四分之一(第 11、13 页)。命题 1 给出两个版本之间的换算关系,并表明:当且仅当惩罚写在同一套单位里时,两个版本加了惩罚的组合才会相同。写法有两种:在一把尺子下选定后换算到另一把尺子,或者直接写在个股头寸上。两种写法都不规定惩罚应当多大,因为每种标准化下的拟合都相同,拟合本身无从选择惩罚(命题 1,第 12 页;第 13 页)。
截距从收益输入这一端进入。惩罚只通过因子暴露作用于组合。只用因子均值构建的组合,全部预测都要经由这些暴露实现;加入截距,则增加了一些头寸,其预期收益并不由因子块承载,惩罚因此几乎触及不到它们(引理 1,第 14–15 页)。
附注:本文特征尺子的逐月统计量。本文所用的特征尺子,是各窗口格拉姆矩阵的指数加权移动平均(EWMA),半衰期为 60 个月(第 17 页)。它在论文的 618 个组合构建月中逐月重新估计。正文使用其中 1975 年 6 月起的 594 个月。其参与维数(这些特征大致相当于多少个同等大小的变动方向)在 17.36 至 22.63 之间。它的中位数为 19.83。变动最大的方向所占份额(最大特征值占迹的比例)在 11.76% 至 15.21% 之间。两个区间均见网络附录表 IA.L.1(第 IA-62 页)。这两个统计量都不是定价风险的个数;尺子只通过因子惩罚影响组合(第 IA-61 页)。数据:论文研究文件(未公开)中的 rolling_geometry.csv。首页图 1 是针对含 153 个特征的特征库所作的另一项描述性展示,并非取自本文。文件与流程见数据与代码。
技术细节
模型把股票 i 下月的超额收益写成(式 1,第 9 页)
r_{i,s+1} = z_{i,s}'\Gamma_\beta f_{s+1} + z_{i,s}'\Gamma_\delta g_{s+1} + z_{i,s}'\Gamma_\alpha + \varepsilon_{i,s+1}.
其中 z_{i,s} 为 132 个特征,f 为三个潜在因子,g 为法玛–弗伦奇五因子;各个 \Gamma 把特征映射为载荷,IPCA 令 \Gamma_\alpha = 0。以度量 Q 做标准化,就是施加 \Gamma_\beta' Q \Gamma_\beta = I_K 与 \Gamma_\beta' Q [\Gamma_\delta, \Gamma_\alpha] = 0:普通尺子取 Q = I_L,特征尺子取窗口内格拉姆矩阵 W_s = Z_s'Z_s/N_s 的平均(式 2–3,第 10 页)。含截距的拟合还把股票层面截距平方的平均值限制在 0.035 以内;这一上限在每个日期都不起作用,618 个滚动拟合中的最大值为 1.5 × 10⁻⁴(脚注 3,第 10 页)。
记 B_t 为股票的因子暴露,\hat\mu_t 为预测,A_{0,t} 为不含因子惩罚的风险矩阵(其中保留一项直接写在个股头寸上的惩罚 \lambda_\Sigma = 0.01),组合求解(式 6,第 11 页)
\max_w \; w'\hat\mu_t \;-\; \tfrac12\, w'A_{0,t}\, w \;-\; \tfrac{\lambda}{2}\,\lVert B_t'w\rVert^2 .
换一种标准化,相当于 B \to BJ^{-1}。加在两个因子协方差上的调整 R 与 R^Q,当且仅当 R^Q = JRJ' 时,才给出相同的个股风险矩阵,从而对任何预期收益向量给出相同的组合;对 R = R^Q = \lambda I(\lambda > 0),这一条件当且仅当 J 为正交矩阵时成立,而从普通尺子到特征尺子的换算,只有在两种度量对潜在载荷本已一致时才是正交的(命题 1,第 12 页;第 13 页)。对任意预期收益向量,惩罚按 B'w_\lambda = (I+\lambda M)^{-1}B'w_0 收缩组合的因子暴露,其中 M = B'A_0^{-1}B;不加惩罚时,截距组合在每种标准化下都相同(引理 1,第 14–15 页)。
5 一个简单例子
试一试。 这里,k 决定尺子的单位:k = 2 表示把因子放大一倍、把股票载荷减半,预测保持不变(第 11、13 页)。(1)k = 1 时,两只股票各占一半。(2)把 k 拖到 2:表中第 1、2 行不动,只有第 3 行的岭项收费从 0.0100 降到 0.0025,因为载荷减半,而收费按载荷的平方计算;股票 1 的占比随之升到 54%。(3)把 k 拖到 0.25:收费增至原来的 16 倍,股票 1 的占比降到 20%。(4)选择“让岭项随单位换算”(论文称之为把惩罚写在同一套单位里):圆点移到虚线上,无论 k 取何值都是 50%;选择“去掉因子岭项”,这里同样是 50%。请留意:股票本身什么都没变,变的只是一个固定常数按什么单位收费。示例中的两个因子互相独立;在论文的两因子例子里,惩罚会让组合偏向在惩罚所用单位下方差较大的那个因子(第 13 页)。
图 1:预测相同、风险相同,岭项收费却不同。两只股票;只改变因子 1 的单位,其余一概不变。
怎么读。股票 1 只随因子 1 变动(因子 1 的均值为 0.01、方差为 0.02,股票 1 的载荷为 1);股票 2 随另一个独立因子变动,其单位始终不变。每只股票的特质方差为 0.01,另有一项直接写在个股头寸上的惩罚,也为 0.01。让岭项随单位换算,是论文提出的补救办法,原文称之为把惩罚写在同一套单位里(writing the penalty in one set of units);去掉惩罚,则是论文的另一个基准(命题 1,第 12 页;表 IA.A.1,第 IA-4 页)。来源:对论文组合规则的示意性算术推演(式 6,第 11 页);不涉及数据文件。
两位厨师按同一份配方做面包,一位用“碗”量面粉,另一位用“半碗”。配方里还有一句“每一份面粉加一撮盐”:盐按“份”放,于是用半碗计量的厨师放的盐更多,面粉却一样。差别出在规则的写法上,不在原料。补救办法有两个:去掉这条规则,或者让它随单位一起换算。在论文里,面粉对应预测,“份”由尺子决定,那撮盐就是加在每个因子方差上的 0.01 惩罚。这个比方也有局限:惩罚不像盐那样是额外的原料,而是一种收费,让规则少持有每个因子;这种收费还随暴露的平方增长;另外,真实的换尺子还会混合各项暴露。
6 研究设计与主要结果
数据为 Jensen、Kelly 与 Pedersen 整理的美国股票月度收益和 132 个特征 (Jensen 等 2023),股票池包括超大盘、大盘和小盘股(剔除微型股),特征每月按横截面排名缩放(第 III.A 节,第 16 页)。每个月,各模型都以此前 120 个月为窗口重新估计,组合持有一个月;组合构建月共 594 个,从 1975 年 6 月到 2024 年 11 月(第 16–17 页)。每个 IPCA 拟合含三个潜在因子,并以法玛–弗伦奇五因子作为可观测因子 (Fama and French 2015)。所有模型都按同一条均值–方差规则给个股定权重,每月把头寸缩放到多空头寸总规模为 1(论文称为单位总敞口)(第 17–18 页)。因子惩罚取 0 至 0.1 的六个值,以 0.01 为参考惩罚(第 17 页)。区间为逐点 95% 区间,来自配对的移动区块自助法(区块 12 个月,重抽样 10,000 次),拟合模型保持固定(第 III.D 节,第 20 页)。除非另有说明,夏普比率均为年化、未计交易成本;成本按每交易一美元多少个基点计算(1 个基点为 0.01 个百分点)。
1. 预测相同,持仓不同。 如果单位无关紧要,两个版本应当持有同样的股票。事实并非如此:在参考惩罚下、按各自的单位计算时,两组权重的“1 减相似度”中位数为 0.17,权重之间的典型距离超过总头寸的一半(第 21 页;表 II,第 24 页)。
表 1:预测一致;只有把惩罚写在同一套单位里,持仓才一致。IPCA 的两个版本(普通尺子与特征尺子),594 个月。
| 比较 | 1 减权重相似度:中位数(最大值) | 两者之间的距离:中位数(最大值) |
|---|---|---|
| 股票预测(相对差距) | — | 4.8 × 10⁻⁶(1.4 × 10⁻⁴) |
| 参考惩罚,写在各自的单位里 | 0.17(0.55) | 0.58(1.04) |
| 特征尺子拟合,惩罚写在普通尺子单位里 | 1.0 × 10⁻¹¹(1.4 × 10⁻⁹) | 4.5 × 10⁻⁶(5.2 × 10⁻⁵) |
| 普通尺子拟合,惩罚写在特征尺子单位里 | 4.8 × 10⁻¹²(2.6 × 10⁻⁹) | 3.1 × 10⁻⁶(6.9 × 10⁻⁵) |
| 两者都去掉惩罚 | 6.2 × 10⁻¹²(4.6 × 10⁻⁹) | 3.5 × 10⁻⁶(9.4 × 10⁻⁵) |
权重相似度即两组权重向量的余弦,“1 减相似度”为 0 表示配置比例完全相同。距离是两个组合权重之差的绝对值之和,两组权重都已缩放到总头寸为 1,因此取值在 0 到 2 之间。预测的相对差距,是两个预测之差相对普通尺子预测的大小(表 II A 栏,第 24 页)。
两个版本是分别估计的,所以这种一致是实际测得的,并非由构造保证。把参考惩罚写在同一套单位里,就只剩一个组合,收益也随权重一致:惩罚写在普通尺子单位里的特征尺子拟合,夏普比率正是普通尺子拟合的 0.69(第 22 页;表 I,第 19 页)。可见持仓差距完全来自同一个惩罚写在两套单位里。
2. 惩罚的大小,以及跨模型族的比较。 图 2 把惩罚从 0 调到参考值的十倍。
图 2:同一个模型,两把尺子,一个惩罚数值。沿因子惩罚变化的夏普比率(未计交易成本),594 个月,1975 年 6 月至 2024 年 11 月(图 1、图 3,第 4、26 页)。
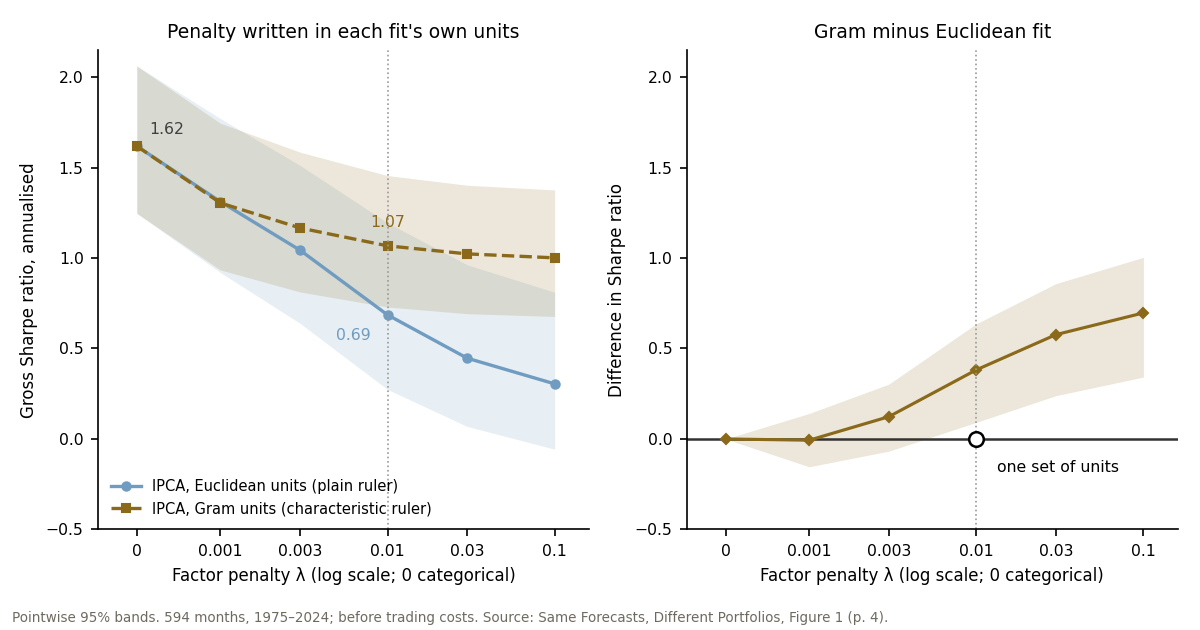
怎么读。每条线是一个组合在因子惩罚 λ 六个取值上的夏普比率;最左边的刻度 λ = 0 在对数坐标上单独画出,虚线标出参考惩罚 0.01。带状区域为逐点 95% 区间,拟合模型保持固定;块长菜单只改变带状区域,读数引用论文的 12 个月区块区间。选择“同一套单位里”时,图中画出的是惩罚写在普通尺子单位里、两把尺子共同持有的那一个组合:论文在 λ = 0 和参考惩罚处直接计算(圆圈),其余各点由命题 1 得出(†)。RP-PCA 与 FF5(法玛–弗伦奇五因子,载荷以特征为工具)按同一规则重新求解(表 I,第 19 页;第 IV.D 节,第 25 页)。来源:《预测相同,组合不同》工作论文(2026 年 10 月)图 1(第 4 页)、图 3(第 26 页)与表 I–II(第 19、24 页);复现文件
10_sharpe_by_lambda_594.csv、10_contrasts_594.csv、13_ladder_594.csv、13_holdings_594.json。 数据 · PNG
这说明什么。 惩罚的大小比它的单位更能左右夏普比率:两个版本去掉惩罚时都是 1.62;到 λ = 0.1 时,普通尺子降到 0.30,特征尺子降到 1.00(表 I,第 19 页)。去掉参考惩罚,普通尺子的夏普比率提高 0.93 [0.61, 1.25],特征尺子提高 0.55 [0.35, 0.77](表 II C 栏,第 24 页)。在单一惩罚数值上做排名,衡量的其实是惩罚:RP-PCA 相对普通尺子 IPCA 的领先,从去掉惩罚时的 −0.08 升到 λ = 0.1 时的 1.03,而 RP-PCA 自身的夏普比率变化不大(表 II,第 24 页;第 25 页)。数据驱动的收缩也消除不了这种依赖:在各自单位下做 Ledoit–Wolf 收缩 (Ledoit and Wolf 2004),两个版本分别为 1.17 和 1.54(表 II,第 24 页)。
3. 模型本来就估计出的截距。 第二项结果固定一个含截距的 IPCA 拟合,只改变预期收益这一项输入:只用因子均值(因子均值组合),或用包含截距的完整拟合均值(截距组合)。两者使用同一个风险矩阵(含惩罚),也不重新估计任何模型(第 V.A 节,第 27–28 页)。不依赖尺子的基准,是不含截距的最佳组合:去掉惩罚的 IPCA,在两把尺子下相同,夏普比率为 1.62(第 14、28 页)。
图 3:同一个拟合,两种均值输入。截距组合与同一拟合的因子均值组合沿因子惩罚变化的夏普比率,594 个月(图 4,第 29 页;表 III,第 30 页)。
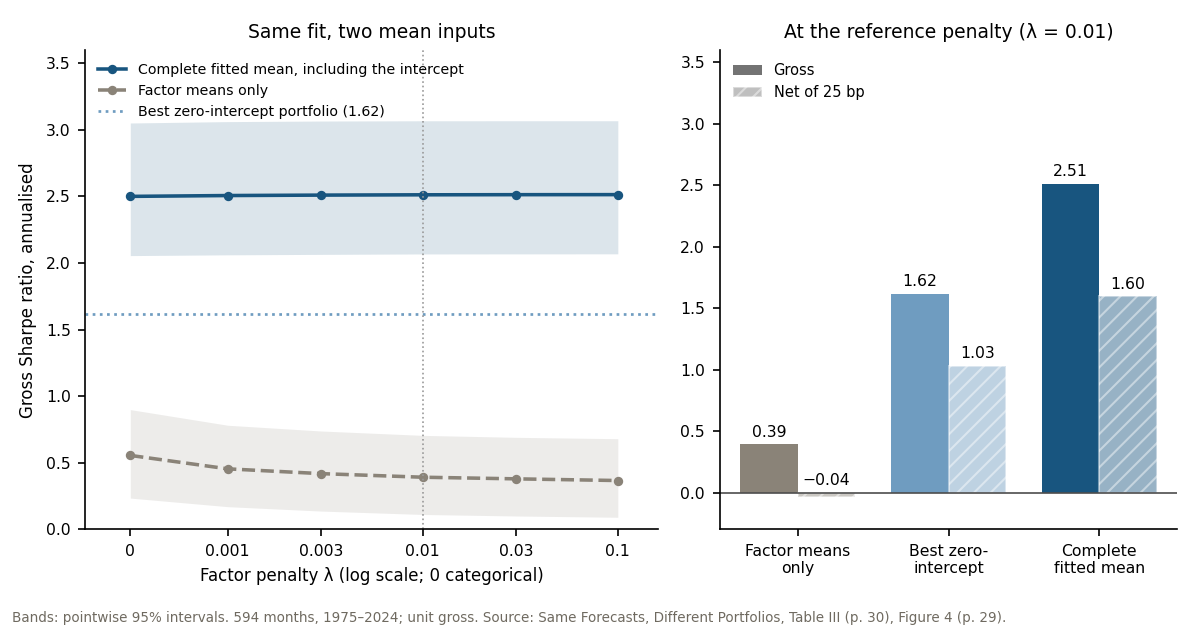
怎么读。粗线为所选的均值输入;虚线为不含截距的最佳组合(去掉惩罚的 IPCA,λ = 0)。未计交易成本时的带状区域为 12 个月区块的逐点 95% 区间。扣费视图按每交易一美元(买入加卖出)收取 25 个基点;这是比例成本,不含价格冲击、融资、融券费用与容量限制,并非可实现的扣费后收益(表 III,第 30 页;脚注 23,第 40 页)。来源:《预测相同,组合不同》工作论文(2026 年 10 月)表 III(第 30 页)、图 4(第 29 页)与表 I(第 19 页);复现文件
14_table3_594.csv、14_intercept_curve_594.csv、15_net_by_lambda_594.csv、15_contrasts_594.csv、13_ladder_594.csv。 数据 · PNG
这说明什么。 因子均值组合的表现与图 2 中的组合相似:去掉惩罚时为 0.56,参考惩罚下为 0.39。截距组合几乎不动:去掉惩罚时为 2.50,在每个正的惩罚值下都是 2.51(表 III,第 30 页)。它比不含截距的最佳组合高 0.89 [0.59, 1.26],这是它相对各比较组合的增益中最小的一个;按 25 个基点扣除成本后,两者分别为 1.60 和 1.03(表 III,第 30 页;表 I,第 19 页)。这一增益依赖于拟合截距在股票之间的分配:每月把截距在股票之间随机打乱,夏普比率平均只剩 0.04,1,000 次打乱中从未超过 0.30(第 29 页;表 IA.M.1,第 IA-65 页)。
4. 增益从哪里来,又能持续多久。 相对不含截距的最佳组合,增益主要来自每美元头寸更低的波动,而不是均值可靠地更高:截距组合的年化均值为 7.6%,基准为 6.6%,差距在抽样误差之内;年化波动率则分别为 3.0% 和 4.1%(第 33–35 页)。在 0.89 的增益中,0.66 来自波动,0.23 来自均值;这一拆分只作描述,且取决于拆分顺序(脚注 21,第 35 页)。对该基准和法玛–弗伦奇五因子回归,截距组合在基准上的载荷为 0.45,年化阿尔法为 4.9%(表 V,第 38 页)。它的盈亏平衡成本(使扣费后平均收益恰好为零的每美元交易成本)为 68 个基点,与基准相同(表 IV,第 35 页)。推迟一个月交易,它的夏普比率从 2.51 降到 1.52,基准从 1.62 降到 1.07(表 III C 栏,第 30 页)。从样本的前三分之一到后三分之一,它的夏普比率从 3.95 降到 1.11,基准的降幅与之相当(第 39 页)。2007 年 10 月以来(206 个月),按 25 个基点扣除成本后,它相对基准的优势为 0.19,区间为 [−0.41, 0.75]:数据分不清这是增益还是损失(第 39 页;表 IA.I.2,第 IA-44 页)。增益中有相当部分是短期溢价:把截距在一组短期收益与交易活跃度特征上的载荷设为零,未计交易成本的夏普比率降到 1.81,增益只剩 0.19 [−0.17, 0.53](第 41 页)。
网络附录中的比较。 图 4 保留了本站此前根据论文 2026 年 9 月研究发布包制作的一幅交互图。图中的数字属于网络附录,标签也沿用论文定名之前的叫法:QZ-IPCA 即特征尺子下的 IPCA,NA-IPCA 即含截距的 IPCA(脚注 3,第 10 页);“关闭截距”即因子均值组合,“仅均值”即截距组合,“完整截距规则”即稳定化截距组合,它还按截距载荷在此前 24 次估计中的变动幅度额外收费(第 IA-33 页)。图中的“核心股票池”即论文的全部股票:剔除微型股后的美国股票(第 16 页)。
图 4:网络附录中的比较:持仓不同,还不等于可靠的收益优势。按月复利的累计收益,头寸缩放至多空头寸总规模为 1,1973 年 6 月至 2024 年 11 月;截距视图为 1975 年 6 月起的 594 个月。
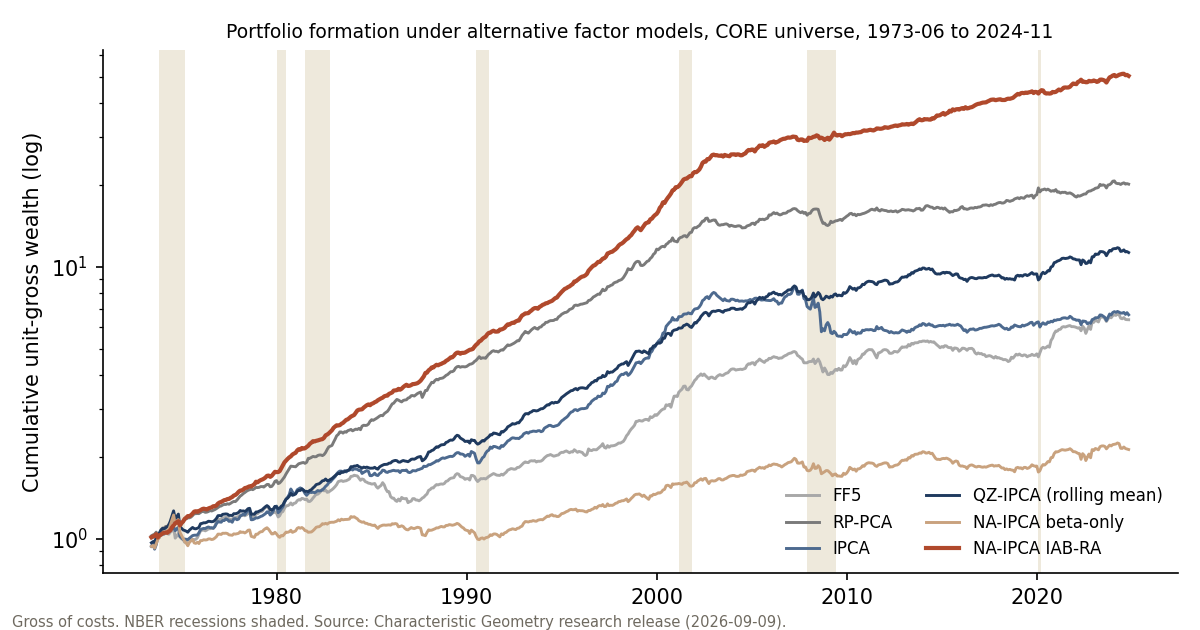
怎么读。“跨模型比较”:618 个月,参考惩罚下 IPCA 为 0.64,RP-PCA 为 1.48,FF5 为 0.68(表 IA.E.3,第 IA-25 页);特征尺子的滚动 60 个月版本为 1.00(表 IA.E.6,第 IA-29 页);稳定化截距组合为 2.4926,因子均值组合为 0.32(表 IA.G.4,第 IA-36 页)。“关闭截距与完整截距规则”:594 个月,按市值分组比较(表 IA.I.3–IA.I.4,第 IA-46–IA-47 页)。“同一拟合,三种输入”:594 个月,三者分别为 0.3917、2.5126 和 2.5347;截距组合的月均收益比因子均值组合高 48.69 个基点,区间为 [34.66, 63.36](表 IA.G.1,第 IA-35 页);618 个月的柱状图见表 IA.G.4(第 IA-36 页)。默认未计交易成本;10 和 50 个基点的视图以及盈亏平衡成本一栏,按单边换手率扣除本站自行计算的代理成本,并非论文的成本模型,也不是可实现的扣费后收益。来源:《预测相同,组合不同》工作论文(2026 年 10 月)网络附录;研究发布包 2026-09-09,
core_monthly_unitgross_returns_source.csv、core_model_performance_618.csv、iab_ra_monthly.csv、beta_only_monthly.csv、Strict24_Main_Performance.csv、Strict24_Paired_Inference.csv、ablation_summary.csv、nber_monthly.csv;发布包未公开;路径由本站复利计算,仅作描述。 数据 · PNG
这说明什么。 在全部 618 个月中,排序与正文相同:截距组合居首,因子均值组合垫底。参考惩罚下特征尺子相对普通尺子的领先在这里较小,EWMA 版本为 0.27 [−0.02, 0.58],区间包含零(表 IA.E.6,第 IA-29 页;脚注 1,第 4 页)。在 594 个月中,稳定化项使夏普比率提高 0.0222 [0.0100, 0.0355],均值不变(表 IA.G.1,第 IA-35 页)。2007 年 10 月以来(206 个月),稳定化截距组合的月均收益比因子均值组合高 0.202 个百分点,区间为 [−0.071, 0.409]:数据分不清这是增益还是损失(表 IA.I.3,第 IA-46 页)。
7 与既有文献的比较
一类文献用大量特征估计因子模型,另一类为组合选择对风险估计做正则化。本文研究的是两者之间的那一步:因子模型的预测和风险怎样变成投资组合。
| 既有文献 | 已有结论 | 本文的补充 |
|---|---|---|
| Kelly 等 (2019) | 以特征为工具刻画时变的因子载荷(IPCA);纳入若干潜在因子后,零截距不被拒绝 | IPCA 留给使用者自定的标准化,决定了因子协方差上任何惩罚的单位;本文把截距用作组合输入,回答的是与其检验不同的问题(第 V.C 节,第 31 页) |
| Jagannathan and Ma (2003);Ledoit and Wolf (2004);Ledoit and Wolf (2017) | 组合约束与收缩相当于对协方差做正则化,可以改进组合选择 | 因子方差上的常数是一种个股层面的惩罚;除非写在同一套单位里,其大小取决于标准化;向单位矩阵收缩同样带有这种依赖 |
| Lettau and Pelger (2020) | 风险溢价主成分分析提取的因子同时兼顾平均收益 | 在同一规则下,它在参考惩罚处相对普通尺子 IPCA 领先 0.80,去掉惩罚则为 −0.08:这一比较衡量的是惩罚(表 II,第 24 页) |
| Kelly 等 (2023) | 由信号构建的组合可以把阿尔法与因子暴露分开 | 截距组合的收益大多来自因子块之外,无需显式对冲;但它并非因子中性(载荷 0.45;表 V,第 38 页) |
夏普比率 2.5 与 Kelly、Pruitt 和 Su 的结论可以并存:在他们的检验中,这个模型的截距与零无法区分。两者回答的是不同的问题。他们的检验问的是:截距载荷(每个特征一个)合在一起是否足够大;组合问的是:按风险矩阵之逆加权、在约两千只股票上加总的截距,每单位风险是否带来平均收益。即使前者不大,后者也可以很大(第 V.C 节,第 31 页)。
《几何框架》与《特征空间度量》表明,尺子决定拟合如何拆分,而不改变拟合本身。本文的特征尺子取自《特征空间度量》,含截距的拟合 NA-IPCA 取自《几何框架》(脚注 3,第 10 页);本文把尺子单位的变化一直追到投资组合,发现它只通过写在这些单位里的惩罚起作用。《尺子很重要》直接在股票上计量这把尺子,追问模型的因子代表了哪些熟悉的头寸,以及用它们对冲需要付出什么。
《解读定价误差》与《预测相同,组合不同》都在问模型“剩下的部分”值多少,但场景不同。前者把一个基于特征的模型的阿尔法成分适度调小(按估计出的比例只保留其中一部分),使平方误差损失下的预测更准;后者在同一次 NA-IPCA 拟合内,把截距纳入预期收益,衡量未计交易成本的组合夏普比率。两者的模型、目标和样本都不同,因此既不相互印证,也不相互矛盾。
所依据的工具早已为人所知。本文的新意在于一项检验和一项度量:只改变固定因子惩罚的单位时,持仓会不会随之改变,以及消除这种依赖的换算;使用完整拟合均值,又如何改变组合对同一惩罚的敏感程度(第 8 页)。它是一项检验,而不是新的估计方法。
8 适用范围
- 除非另有说明,均未计交易成本。 扣费数字按每交易一美元(买入加卖出)收取 25 个基点,这是比例成本,不含价格冲击、融资、融券费用与容量限制(脚注 23,第 40 页)。这些结果是基于模型配置的条件性证据,并非经过核实、可实际执行的交易策略:股票只有在下月收益有记录时才进入当月样本,各特征的时点可得性也未经独立核实(第 7 页;脚注 7,第 16 页)。
- 逐点区间。 区间以滚动拟合为固定条件,也不是跨惩罚值或跨组合的联合区间。正文选用 594 个月样本和不带稳定化项的截距组合,是在两种样本、两种规则都算完之后作出的选择,区间没有为此调整(脚注 2,第 6 页;脚注 12,第 20 页)。在全部 618 个月中,两把尺子之间相应的差值为 0.27,其区间包含零(脚注 1,第 4 页;表 IA.E.6,第 IA-29 页)。
- 一个模型,而非模型族。 命题 1 联系的是同一模型的两种标准化;它说明惩罚应如何在两者之间换算,而不规定惩罚强度,也不把预测本就不同的模型族等同起来(第 4、13 页)。
- 未证明截距是错误定价。 截距是拟合均值中因子块未吸收的部分;它反映的是定价误差、遗漏因子还是条件动态,本文不作预设,其阿尔法只是相对于所列回归变量的残差(第 5–7 页;脚注 18,第 27 页)。
- 没有最好的尺子或惩罚。 两把尺子的排名随惩罚而变,而拟合本身无法选出惩罚(第 13、23 页)。在本样本中,因子协方差并不需要收缩;不依赖样本的设计准则,是把任何惩罚都写在个股单位里(第 26 页)。
参考文献
Fama, Eugene F., and Kenneth R. French. 2015. “A Five-Factor Asset Pricing Model.” Journal of Financial Economics 116 (1): 1–22. https://doi.org/10.1016/j.jfineco.2014.10.010.
Jagannathan, Ravi, and Tongshu Ma. 2003. “Risk Reduction in Large Portfolios: Why Imposing the Wrong Constraints Helps.” Journal of Finance 58 (4): 1651–83. https://onlinelibrary.wiley.com/doi/10.1111/1540-6261.00580.
Jensen, Theis Ingerslev, Bryan Kelly, and Lasse Heje Pedersen. 2023. “Is There a Replication Crisis in Finance?” Journal of Finance 78 (5): 2465–518. https://onlinelibrary.wiley.com/doi/full/10.1111/jofi.13249.
Kelly, Bryan T., Seth Pruitt, and Yinan Su. 2019. “Characteristics Are Covariances: A Unified Model of Risk and Return.” Journal of Financial Economics 134 (3): 501–24. https://www.sciencedirect.com/science/article/abs/pii/S0304405X19301151.
Kelly, Bryan, Semyon Malamud, and Lasse Heje Pedersen. 2023. “Principal Portfolios.” Journal of Finance 78 (1): 347–87. https://doi.org/10.1111/jofi.13199.
Ledoit, Olivier, and Michael Wolf. 2004. “A Well-Conditioned Estimator for Large-Dimensional Covariance Matrices.” Journal of Multivariate Analysis 88 (2): 365–411. https://doi.org/10.1016/S0047-259X(03)00096-4.
Ledoit, Olivier, and Michael Wolf. 2017. “Nonlinear Shrinkage of the Covariance Matrix for Portfolio Selection: Markowitz Meets Goldilocks.” Review of Financial Studies 30 (12): 4349–88. https://academic.oup.com/rfs/article-abstract/30/12/4349/3863121.
Lettau, Martin, and Markus Pelger. 2020. “Estimating Latent Asset-Pricing Factors.” Journal of Econometrics 218 (1): 1–31. https://www.sciencedirect.com/science/article/abs/pii/S0304407620300051.
Liu, Mingyang. 2026a. A Geometric Framework for Identification in Characteristic-Based Factor Models. https://doi.org/10.2139/ssrn.7013178.
Liu, Mingyang. 2026b. Characteristic-Space Metrics in Factor Models: Identification and Inference. https://doi.org/10.2139/ssrn.7445120.
引用
BibTeX
@report{liu2026forecasts,
  author = {Liu, Mingyang},
  publisher = {Imperial Business School, Imperial College London},
  title = {Same Forecasts, Different Portfolios: Factor Normalization
    and Regularization},
  date = {2026-10},
  url = {https://mingyangliu.org/zh/research/same-forecasts-different-portfolios.html},
  langid = {zh}
}
请按如下格式引用:
Liu, Mingyang. 2026. Same Forecasts, Different Portfolios: Factor
Normalization and Regularization. Working paper. Imperial Business
School, Imperial College London. https://mingyangliu.org/zh/research/same-forecasts-different-portfolios.html.