刘明杨
中文简历(PDF) · 英文简历(PDF) · 工作论文 · 电子邮件 · 帝国理工学院个人主页 · 领英(LinkedIn)
我是量化研究员,现任帝国理工学院量化金融卓越中心(Imperial Centre of Excellence in Quantitative Finance)访问研究员,合作导师为 Robert Kosowski 教授。我的主要研究领域是实证资产定价、机器学习与金融大数据、金融计量。研究中,我使用大规模股票特征面板和正则化的机器学习估计方法。我追问:因子模型给出的答案,包括因子、阿尔法和投资组合,哪些反映了数据中的信息,哪些只反映了模型衡量这些信息的方式。我从识别与统计推断出发,逐层追踪这些衡量上的选择,直到投资者最终的持仓。
在论文之外,我也为投资研究开发并测试分析工具:研究工具栏目逐一展示,每项工具都在一个存档研究示例上运行,并写明输入、输出和局限。
我于 2026 年获帝国理工学院金融学博士学位,导师为 Paolo Zaffaroni 教授与 Pasquale Della Corte 教授;2020 年以 Distinction(最高等级)成绩获金融学研究型硕士学位(MRes in Finance)。此前,我在密歇根大学获理学学士学位(经济学、数学双专业;数学专业方向:金融数学与风险管理),在哥伦比亚大学获经济学硕士学位(金融计量方向),硕士论文导师为白聚山(Jushan Bai)教授。
研究之外,我以独立顾问身份提供量化研究与人工智能咨询。我曾为国内一些小型量化投资团队提供咨询,内容涉及研究数据与特征工程、基于 Python 的量化研究平台搭建,以及 AI 编程智能体在研发中的应用(详见独立咨询)。
姓名写法:刘明杨 · Mingyang Liu · Liu Mingyang · 刘杨 / Yang Liu(法定姓名,部分目录沿用)。
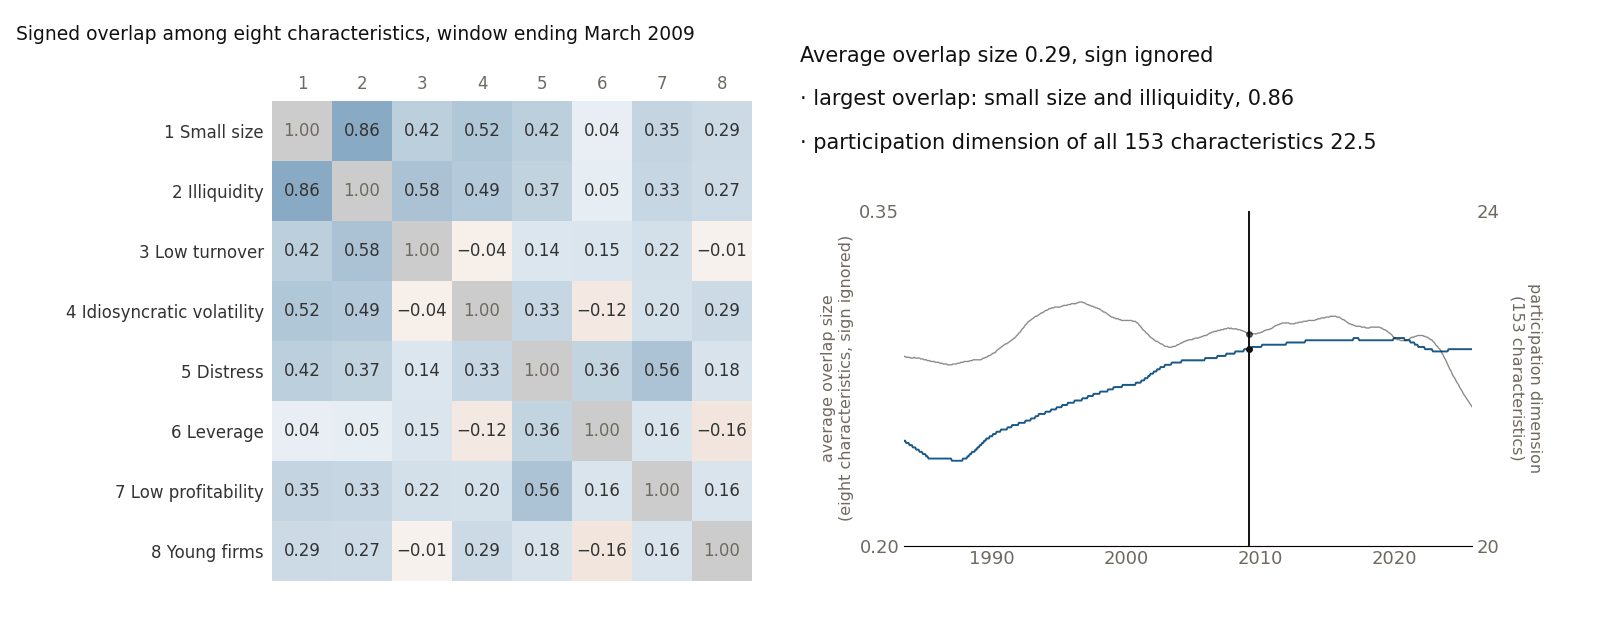
| 特征 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|
带符号重叠的刻度:+1 表示同一批股票在两个特征上都得高分,−1 表示相反。0 表示分数不同步。每个特征都已调整符号,使行名所指的特质得高分。对角线格按构造恒为 1。读数中的平均值不计正负。
用滑块或方向键移动窗口,表格随之更新。
在各窗口中,重叠大小的平均介于 0.24 至 0.29。小市值与低流动性之间的重叠介于 0.61 至 0.93。整个特征库的参与维数介于 21.7 至 22.9。
图 1 展示的,是特征尺子量出、而普通尺子直接假定为零的部分:八个彼此相关的特征在股票之间重叠多少,从 1983 年到 2025 年逐月重新估计。1下一节先说明什么是尺子,再说明换一把尺子为什么会改变两件事:收益在因子与“没有被任何因子解释的部分”之间怎样拆分,以及投资者持有什么。
研究主线
信息相同,答案却不同:相信因子模型的结论之前,先检查它用的尺子。
因子模型用少数几个共同驱动因素来解释大量股票的收益。基于公司特征(规模、价值、动量等)的因子模型会给出三个答案:哪些风险被定价,预期收益中还有多少没有被模型的因子解释(即阿尔法),以及应当持有什么。我想弄清:每个答案中,有多少来自数据里的信息,又有多少来自并不增加任何信息的选择。其中最核心的选择是“尺子”。要说清一只股票的预期收益有多少归功于哪个驱动因素,模型得先判断两个特征方向是否真的不同、各自有多大;做这个判断的规则,就是尺子;严格地说,即特征空间上的一种度量(内积)。我让这把尺子由数据本身估计出来。我证明,换尺子会改变收益在因子与“没有被任何因子解释的部分”(即截距;阿尔法与之相近,但阿尔法是相对于某个指定基准模型而言的)之间怎样拆分,但不改变拟合优度;我还把尺子本身的估计误差计入置信区间。在此基础上,我追问两件事:“更小的阿尔法”究竟反映了什么?尺子,以及它所衡量的特征库,又如何改变投资者的持仓?研究者和投资经理经常调整这类约定,而约定一变,很容易被误当成新发现。
给每个特征一个权重再相加,每只股票就得到一个分数;这样的加权组合称为特征方向(它不是投资组合)。普通尺子(欧氏度量)只看方向的权重本身;特征尺子(格拉姆度量)则看这个方向给真实股票打出的分数:分数通常有多大,两个方向的分数在股票之间是否同高同低。
尺子,是模型用来衡量一个特征方向有多大、两个特征方向重叠多少的规则。两个价值信号若总是选中同一批便宜的股票,特征尺子会把它们算作重叠,普通尺子却把它们当作互不相关。
建议阅读顺序
每篇论文都固定其他一切,只改变一项选择,再看哪些结果随之改变。
- 用哪把尺子?→《几何框架》(较早、范围较宽的版本)
- 尺子决定了什么,又有多可靠?→《特征空间度量》
- 更小的阿尔法意味着什么?→《解读定价误差》
- 预测相同,组合为何不同?→《预测相同,组合不同》
- 目标相同,持仓为何不同?→《尺子很重要》
研究
基于特征的因子模型中识别问题的几何框架
数据相同,因子却可能不同:哪些特征方向算作彼此不同,取决于所用的尺子。本文从特征在股票之间的分布与重叠中取得这把尺子(格拉姆度量),并在其上建立识别、无套利约束与推断。
本文是《特征空间度量》较早、范围较宽的版本。
英文题目 A Geometric Framework for Identification in Characteristic-Based Factor Models · 论文页面 · PDF(英文) · SSRN
因子模型中的特征空间度量:识别与推断
拟合收益相同,拆分却不同:尺子决定收益如何归于潜在因子(从数据中推断出的共同驱动因素)、可观测因子(如市场因子)与截距。当尺子由数据估计时,它的误差也必须计入置信区间。
英文题目 Characteristic-Space Metrics in Factor Models: Identification and Inference · 论文页面 · PDF(英文) · SSRN
如何解读估计的定价误差:来自基于特征的收益预测的证据
尺子相同,目标却不同:阿尔法变小,可能是因为因子解释得更多,也可能是因为因子要解释的预期收益估计(目标)变了。本文在同一批股票上交叉搭配各模型的预期收益估计与因子,发现等权训练与市值加权训练之间阿尔法的较大差距主要来自目标不同。
英文题目 Interpreting Estimated Pricing Errors: Evidence from Characteristic-Based Return Forecasts · 论文页面 · PDF(英文)
预测相同,组合不同:因子标准化与正则化
预测相同,组合却不同:组合规则给每个因子的风险加上一个小常数,它是对因子押注的惩罚,写在尺子的单位里,于是同一个数给出两个组合。惩罚数值相同时,同一模型预测几乎一致的两个版本,未计交易成本的夏普比率(每单位波动率的平均收益)分别为 0.69 和 1.07(表 I,第 19 页)。把惩罚写在同一套单位里,或者去掉它,就只剩一个组合。
英文题目 Same Forecasts, Different Portfolios: Factor Normalization and Regularization · 论文页面 · 论文(PDF,英文)
尺子很重要:因子暴露、归因与投资组合风险
目标相同,持仓却不同:收益拟合得更好的因子模型,未必能代表投资者关心的头寸;一次对冲能否剔除模型的因子载荷(股票随各因子变动的强弱),取决于衡量载荷的尺子。把特征库从 36 个扩充到 153 个,拟合有所改善,载荷能复现的动量与规模头寸却更少;用普通尺子对冲价值头寸,按股票权重的平方计,仍有 46.10% 落在模型的载荷空间里(第 6–7 页)。
英文题目 The Ruler Matters: Factor Exposures, Attribution, and Portfolio Risk · 论文页面 · 论文(PDF,英文) · 幻灯片,一小时报告(PDF,英文) · 视频讲解(6 分钟,英文)
进行中的研究。《因子暴露还是截距?基于无套利 IPCA 的公司债券预期收益识别》,与 Paolo Zaffaroni 合著(撰写中);与洛桑联邦理工学院(EPFL)、瑞士金融研究院的 Semyon Malamud 教授开展合作研究,探讨如何基于线性样本外收益预测构建投资组合。详见进行中的研究。
学术经历
联系方式
| 电子邮件 | mingyangliu.org@outlook.com(工作)· yang.liu19@imperial.ac.uk(学术) |
| 帝国理工学院个人主页 | profiles.imperial.ac.uk/yang.liu19 |
| 领英 | linkedin.com/in/mingyang-buweinan |
| ORCID | 0009-0008-5418-2563 |
特征:Jensen–Kelly–Pedersen 数据库的 153 个美国股票特征(JKP153),与《尺子很重要》所用的特征库相同;每个特征在月内按排名标准化、以 0 为中心,并调整符号,使行名所指的特质得高分。每个窗口取截至所示月份的 240 个月,把这些特征逐月的 153×153 二阶矩矩阵等权平均。窗口终点从 1983 年 6 月到 2025 年 11 月。共 510 个窗口,任何窗口都不使用未来月份。240 个月等权窗口是本图自己的选择。《预测相同,组合不同》报告的是特征尺子的滚动 60 个月版本、等权 120 个月版本与指数加权移动平均(EWMA)版本(第 17 页),路径随窗口而变。表格取其中 8×8 的分块:市值(符号反转)、Amihud 非流动性、换手率(反转)、特质波动率、财务困境得分(Ohlson O 值)、债务与市值之比、经营盈利(反转)与公司年龄(反转),并把对角线缩放为 1,因此各格近似于相关系数。这个分块是特征库中特意选出的高重叠角落,不是有代表性的样本;全部 153 个特征之间重叠的汇总见《特征空间度量》表 I(第 31 页)与图 1(第 32 页)。每个窗口中重叠最大的一对都是小市值与低流动性;Amihud 非流动性由美元成交量构造,与市值高度重叠在意料之中。会计数据只在新的财务报表公布后才更新,覆盖范围、缺失值的比例和股票池也随时间变化;除了公司之间相对位置的变化,这些变化同样会移动这些平均值。时间轴中的参与维数由完整的 153×153 窗口矩阵计算,不是由 8×8 分块计算,介于 21.7 至 22.9。这是描述性的可视化,不是新的估计量,也不是因果检验。↩︎